3.17 训练 Composer 处理更长周期任务 · Cursor
cursor在自己的benchmark中发现,在高难度真实世界编程任务中,更好的表现与 更充分的思考和更多的代码库探索 直接相关。但挑战在于,agent trace的增长速度要快于模型上下文长度的提升速度。许多agent框架会尝试通过在workflow中将compact作为中间步骤,来绕开这个问题。当agent接近上下文限制时,框架会将上下文压缩到更短的长度,然后从中断处继续任务。
模型上下文长度受到什么技术的限制?跳转Context Window
compact一般分为两种方式:
- 在文本空间中借助prompt驱动的摘要模型进行处理
- 通过滑动上下文窗口,让模型丢弃较早的上下文
这些方法的共同缺点是:可能导致模型遗忘上下文中的关键信息,从而在推进长程任务时降低其效果。研究人员也开始探索潜空间的compact方法,这种方法将上下文记忆作为向量,但目前这些方法会比基于文本的方法慢得多。(此处需调研最新进展)
cursor将compact融入到训练中,每次rollout都可能包含多次compact,这意味着自我总结本身也是奖励机制的一部分。这既会提高良好轨迹中agent响应的权重,也会提高让轨迹得以奏效的compact的权重。同时,丢失关键信息的compact则会被降低权重。
cursor也展示了模型在解决一个较难问题的过程中产生的自我总结:
Composer 的自我总结
对话摘要
用户目标
构建一个名为 doomgeneric_mips 的 MIPS 小端 ELF 文件,使 node vm.js 能够运行它:stdout 应正常工作,且帧数据应使用提供的 doomgeneric_img.c(以及 /app/doomgeneric/ 下的 doomgeneric 源码)写入 /tmp/frame.bmp。
<br>
已实现内容
-
为 JS VM 提供独立 libc(
/app/mips_freestanding/)
- VM 实现了 Linux 风格的 open 标志,但系统调用号并非真实的 MIPS Linux 编号(0=read, 1=write, 2=open, 3=close, 8=lseek, 201=time, 38=rename, 39=mkdir)。普通的 mipsel-linux-gnu-gcc + glibc 会使用 4003+ 风格的编号,无法正常工作。
-my_libc.c+vm_syscall.h:包含上述系统调用,以及精简版的malloc/free/realloc、stdio(fopen/fread/fwrite/…)、字符串处理、printf子集、qsort、sin/atan/fabs、strdup、abs、system桩函数等。 -
doomgeneric_img.c(位于/app/doomgeneric/doomgeneric/)
- 使用my_stdlib.h。
-DG_DrawFrame:将每一帧写入/tmp/frame.bmp(32 位 BMP)。
-main:安全处理argc/argv(若为 null 则使用备用 argv),然后执行doomgeneric_Create→ 无限doomgeneric_Tick()循环(与其他 doomgeneric 前端模式相同)。
<br>
3. 构建 — /app/doomgeneric/doomgeneric/Makefile.mips
- 使用 mipsel-linux-gnu-gcc、-fno-pic -mno-abicalls、-static -nostdlib、-Wl,-e,main,链接 libgcc。
- 必须禁用 PIC 以避免以下问题:在 $t9 未设置的情况下从 main 入口进入会破坏 GP 相对 GOT;禁用 PIC 解决了该问题。
- 目标文件:完整的 doom 文件列表,以 doomgeneric_img.o 替代 xlib;不含 deh_str.o(仅头文件)。
- i_system.c:DEFAULT_RAM / MIN_RAM 可通过 -D 覆盖;构建时使用 -DDEFAULT_RAM=4 -DMIN_RAM=4 以缩减 VM 的内存区域。
- 输出:/app/doomgeneric_mips。请勿 strip——VM 从 .symtab 解析 main。
<br>
4. vm.js 变更(对下一位助手而言很重要)
- OOM 问题:当 doom 访问大量内存字时,普通的 {} 内存对象会导致 V8 内存溢出。
- runElf:现在分配 Uint32Array 低地址 RAM(从 0x400000 起 96MB)+ 栈(从 0x7f800000 起约 8MB),将 .text/.data/.rodata 加载到低地址缓冲区,返回 { lowMem, stkMem, memLowBase, …, entry_point } 而非一个巨大的 memory 对象。
- MIPSVM:memGetWord / memSetWord 通过上述缓冲区路由;稀疏的 this.memory 在写操作中实际上已被弃用(OOM 修复);memGetWord 越界时返回 0(可能掩盖缺陷)。
- 所有 lw/sw/字节辅助函数及 runProgram 指令获取均使用 memGetWord/memSetWord。脚本末尾将 vm._lowMem 等与 runElf 的返回值连接。
<br>
错误与修复(简述)
- 系统调用号错误 → 自定义 libc + VM 系统调用号。
- 链接错误 → 添加了
strdup、strstr、abs、putchar、puts、atof、system、remove/rename;移除了不存在的deh_str.o。 - 入口处立即崩溃 → 使用
-fno-pic -mno-abicalls。 - Node 内存溢出 → 改用 ArrayBuffer 支持的 VM 内存;移除了无界的
this.memory写操作。 r_segs.c:SHRT_MAX→ 已添加到limits.h。
仍存在的问题 / 下一位助手待办事项
/tmp/frame.bmp在测试中从未生成:运行以Program terminated at PC=0x400151、Executed 626581578条指令结束。0x400150是abort符号(自跳转死循环)。因此某处最终跳入了abort,而非正常的游戏循环绘帧流程。- 4MB 内存区域(
DEFAULT_RAM=4)对于真实 IWAD 运行可能过小 → 导致Z_Malloc/ OOM 类失败或其他未定义行为;建议尝试DEFAULT_RAM=6,在my_libc.c中增大HEAP_SIZE(之前已缩减至 14MB),并确保memGetWord越界不会掩盖真实错误。 - 具体后续步骤:找出谁调用了
abort(例如 trap、libgcc 路径、内存分配失败);修复非 Windows 下的 I_Error 路径(当前可能调用ZenityErrorBox或走异常路径);确认doomgeneric_Create→D_DoomMain→ … →doomgeneric_Tick/D_Display→DG_DrawFrame调用链;确认 VM 中fopen("/tmp/frame.bmp","wb")+SYS_close刷新正常;反复运行直到/tmp/frame.bmp成功生成且 stdout 输出正常。
路径
- ELF:
/app/doomgeneric_mips - 构建:
/app/doomgeneric/doomgeneric/Makefile.mips - 前端:
/app/doomgeneric/doomgeneric/doomgeneric_img.c - Libc:
/app/mips_freestanding/my_libc.c、/app/mips_freestanding/include/* - VM:
/app/vm.js(已修补内存模型) - 本地测试用 IWAD:
/app/doom1.wad(用于测试)
3.23 快速正则搜索:为 agent 工具构建文本索引 · Cursor
一篇较硬的文章,备好咖啡,准备啃硬骨头~
大多数agent框架在提供搜索工具时,默认使用 ripgrep (rg),它是经典grep的替代品,以速度快而闻名,因为他的发明者 Andrew Gallant在“如何让正则匹配更快”这件事上投入了非常多的思考:ripgrep is faster than {grep, ag, git grep, ucg, pt, sift}
但不管ripgrep在单个文件内容中匹配有多快,它都有一个严重限制:它必须在所有文件内容上进行匹配。尽管 rg 本身非常优化,在monorepo中,它仍然可能需要扫描几十万个文件。代码库越大,磁盘 I/O、文件遍历和字符串匹配的总成本就越明显,一次搜索可能跑到十几秒。这回严重拖慢人与agent交互的效率。而cursor也在尝试为agent查找文本时执行的核心操作构建专门的索引。博客先带领我们回顾了一些经典算法。
倒排索引
简单点说,就是把「文档里有哪些词」反过来存成「每个词出现在哪些文档里」
而倒排本质上就是把搜索时的计算,提前到了建索引的阶段。但倒排依赖于分词器,将文档拆分成一系列token,虽然我们可以优化分词策略来适应不通场景,但对于代码场景来说,我们更需要正则匹配。
比如:
const userId = getUserId();
const adminId = getAdminId();
普通的倒排擅长搜索userId,getUserId,而正则可以搜get.*Id,而get.*Id 本身不是一个提前能确定的 token,因此我们需要一种更好的分词方式。
三元组分解
关于什么是三元组,你可以直接询问我的jerry,在这里就不进行阐述。而真正的复杂问题是正则表达式中有很多语法,我们需要对这些语法进行解析,使用“启发式方法”来判断哪些三元组可以从实际文本的表达式片段中提取出来。相比于二元组和四元组,三元组在posting list的长度和 key的数量之间取得了较好的平衡,不会因为粒度过粗导致posting list过长,也不会因为粒度果过细而产生过多的索引key。
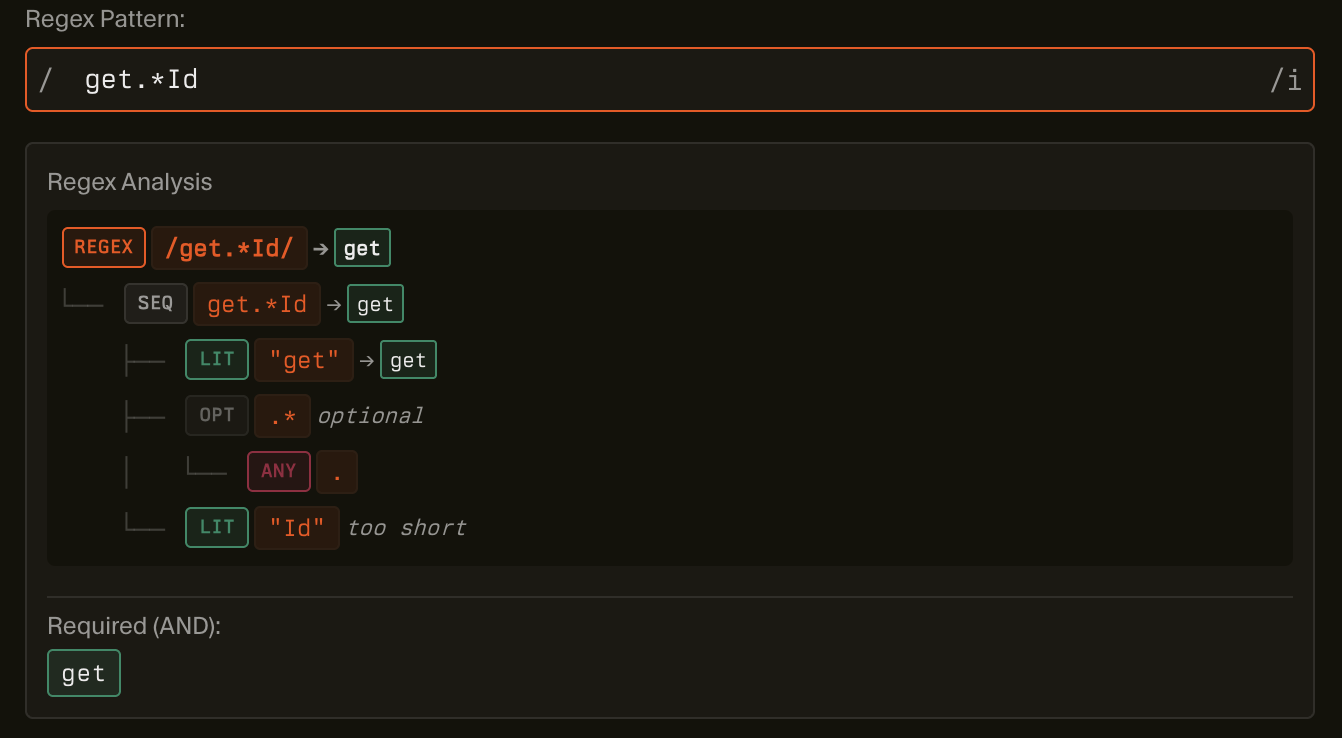
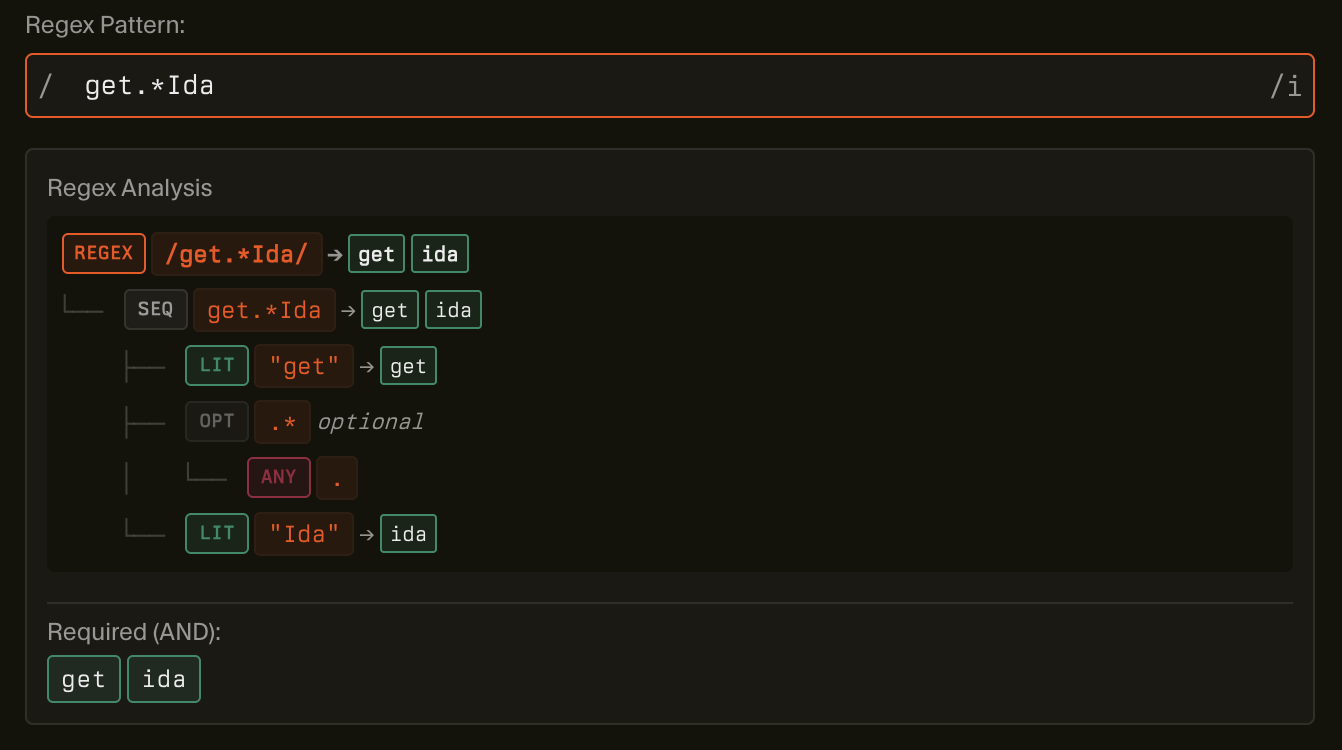 在 trigram 索引这一层,不够 3 个字符的片段通常就不能单独拿来查索引,但会在执行regex的时候进行检查。显然这种策略会比逐个文件扫描并匹配整个代码库要快得多。但显然,这个方法也有很多不足:
- 索引体积并不小,而且在查询时的分解必须做权衡。如果使用简单的启发式方法,你会把查询分解成很少的几个三元组,这会导致需要匹配的候选文档很多。如果使用复杂的启发式方法,你可能会得到几十甚至上百个三元组,而从倒排索引中加载所有这些三元组对应的倒排列表的开销,可能会慢到还不如直接从头扫描所有内容。
后缀数组
cursor在博客里讨论了Nelson Elhage 在 2015 年为他的 livegrep 网络服务开发是使用的一个方法。关于后缀数组的细节你也可以问问jerry。后缀数组搜索就是把“任意子串搜索”转换成“在所有后缀上的前缀搜索”。我们将所有的后缀按照字典序排好,就可以通过二分法快速找到我们所需要的子串。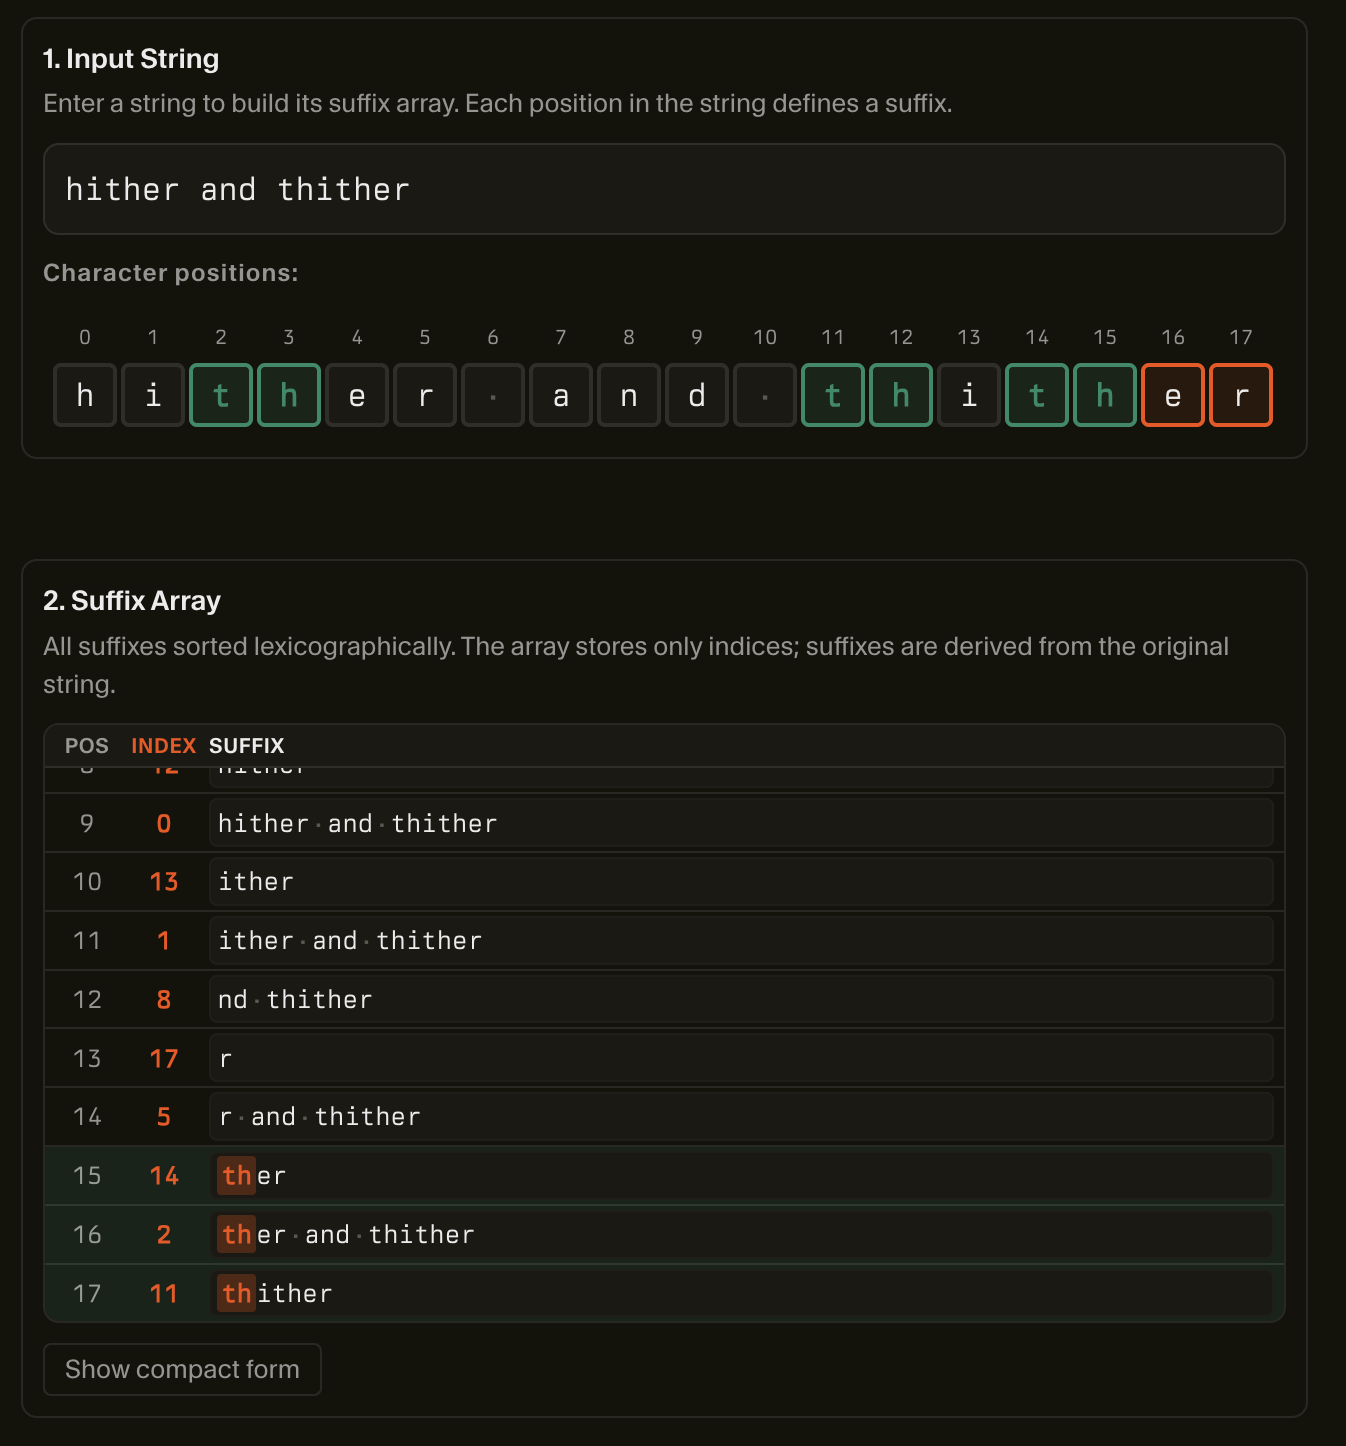 而suffix array 能直接搜索任意长度的确定字符串,并且能高效的为正则表达式找到所有潜在的匹配位置。但后缀数组必须基于一个输入字符串来构造,这是一个很大的限制。当我们为一个大型代码库建立索引时,要将所有内容先拼成一个字符串,然后根据这个字符串构建后缀数组,这会导致动态更新索引的成本非常高。
带概率掩码的三元组查询
想象一下你是github平台搜索工具的开发者,面对庞大的代码数据,你要如何创建一套又快又准的搜索引擎,还要支持正则语法。如果你按照我们之前说的倒排,三元组,那么创建得到的posting list会非常庞大,根本无法高效搜索。
可是我们之前提到,二元组太宽泛,它们的posting list大到无法管理;四元组太具体,让我们的索引中出现过多的key。而似乎在实践中我们发现,理想的大小更像是3.5-gram?但我们不能将一个字符劈成两半...
但我们可以在posting list中增加一些额外信息,用来表示紧跟在三元组之后的“第四个字符”,用一个bloom filter来做这件事。
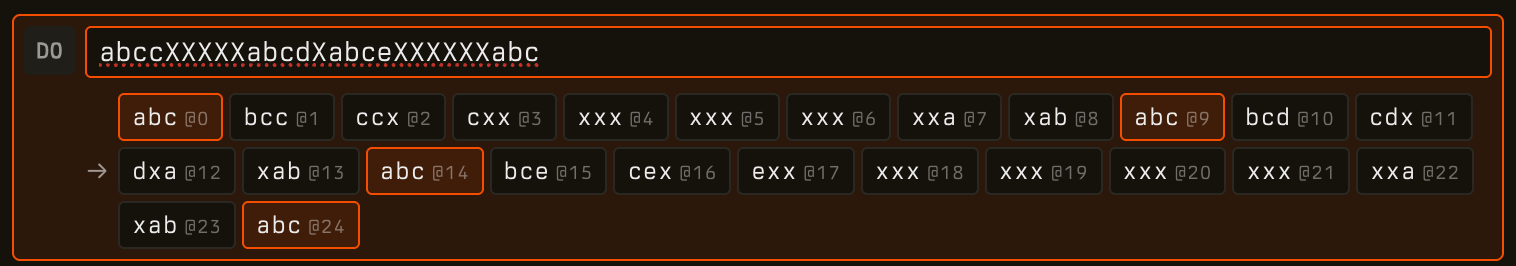
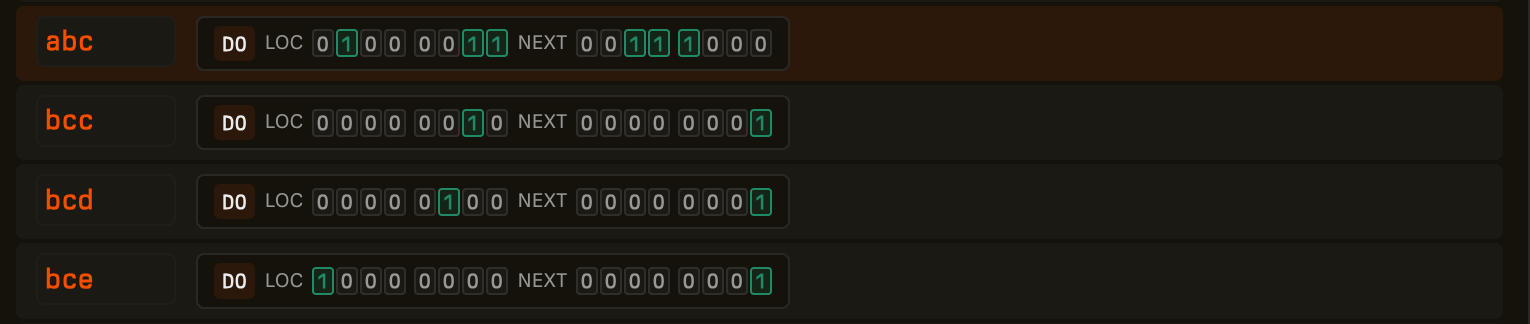 我们可以通过对三元组的位置%8,用一个8位的locMask来存储三元组的位置,就像图片中的'abc',取余后的位置是0,1,6,0。而'abc'这个三元组的后继字符有{c,d,e},通过计算后继字符的hash(这里使用hash(char) = ASCII(char) % 8),我们得到nextMask,在这幅图中c,d,e的hash为3,4,5。
locMask可以判断两个三元组是否可能相邻,比如我们要搜索abcd,那么abc应该在位置x,bcd应该在位置x+1,如果两个三元组连这种位置关系都对不上,那这个文档就直接排除。
nextMask可以判断三元组后面紧跟过哪些字符的hash,那么我们在搜索abcd时,如果abc的nextMask连d都没有,则直接排除这个文档。
因此这两个方式可以快速排除概率为0的文档,尽量减少需要扫描的潜在文档数量。聪明的你会注意到,当文档数量足够多的时候,bloom filter很可能会被“灌满”,此时它会匹配所有内容,那我们又回到了最开始索引性能水平。
稀疏 N-grams:更聪明的 trigram 选择
传统的trigram索引会提取每一个连续的3字符序列,这会产生大量冗余,因为每一个trigram的字符会在相邻的trigram中被重复。而sparse n-gram会提取一定数量的随机n-gram,并且每个n-gram的长度也是随机的。
这里的“随机”不是真正意义上的随机,而是对文档的每一对字符分配一个“权重”,这个权重可以是任何值,只要是确定性的即可。比如我们可以计算这两个字符的crc32 hash。而sparse n-gram则会提取“两端权重大于内部包含的所有权重”的这类子串。这可能会生成比trigram还要多的子串。但由于n-gram是以确定性的方式生成的,这就使得我们在查询时可以做一些非常重要的优化策略。如果你想要了解如何构建索引,可以直接访问cursor的博客,它们做了非常专业且易懂的动画帮助理解。
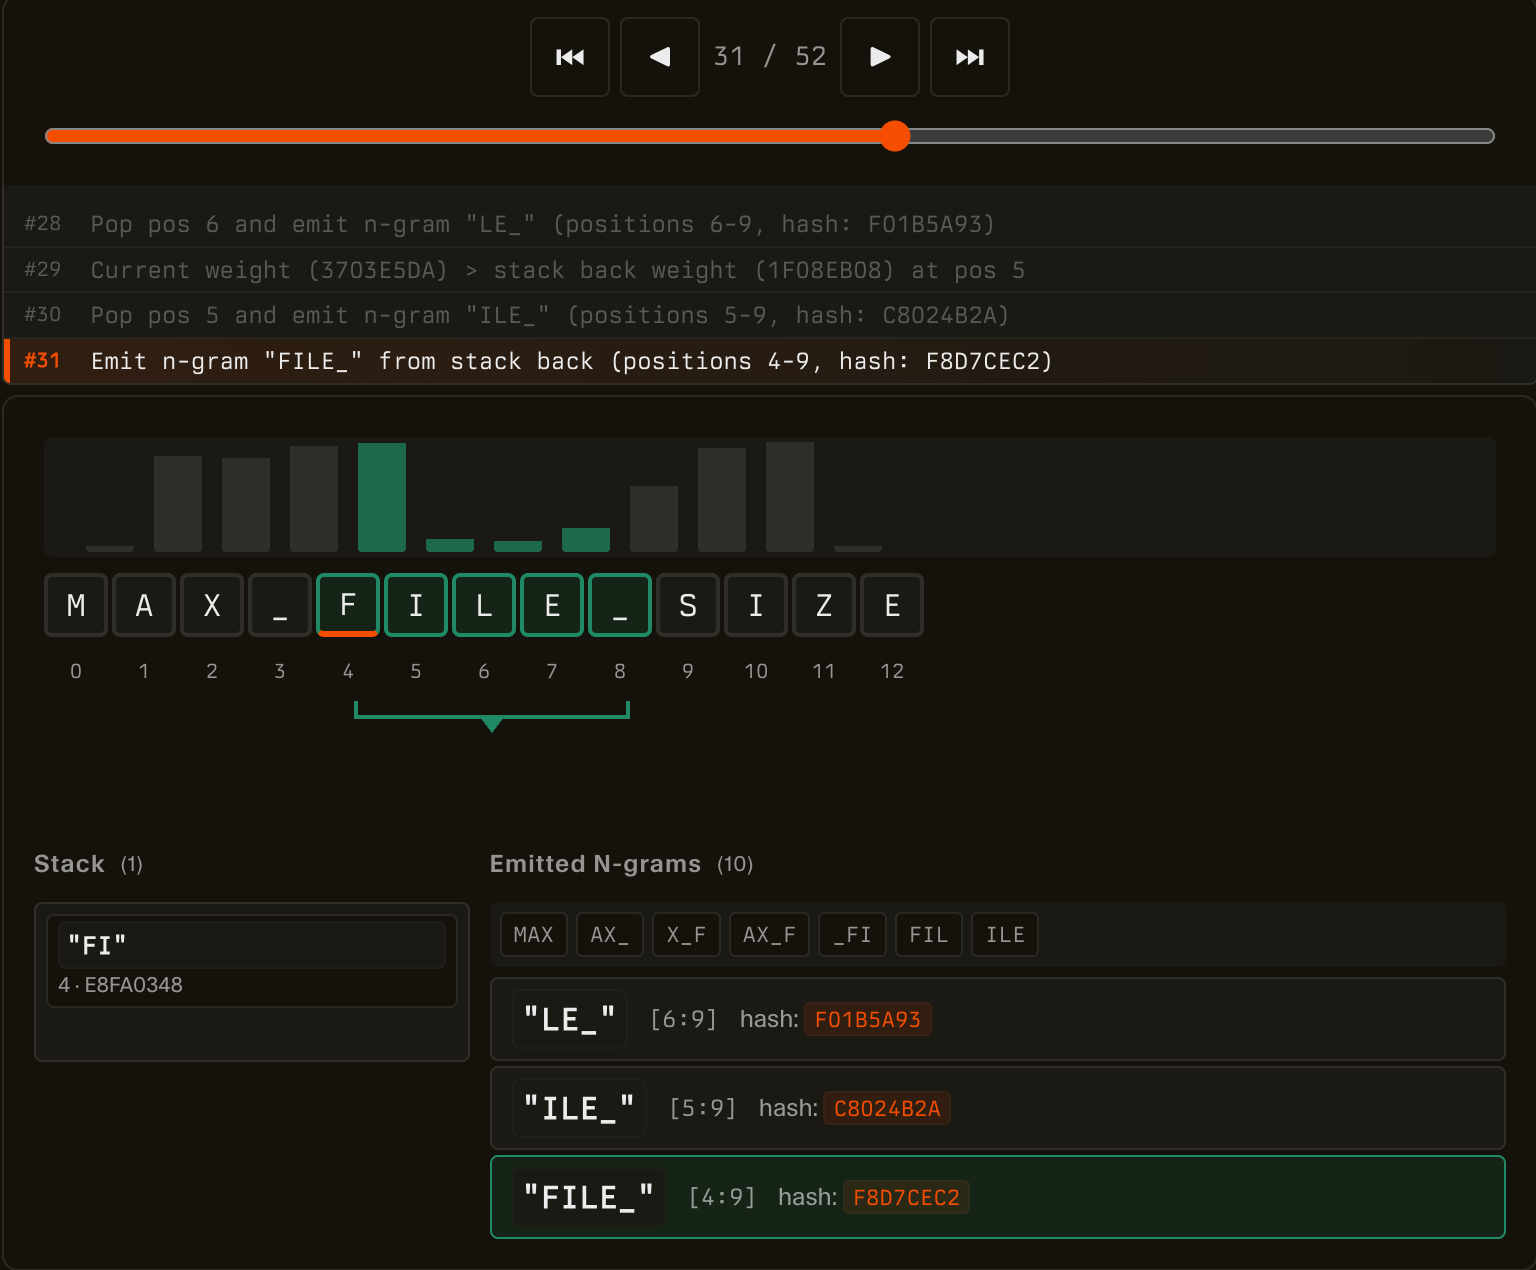 我们在建立索引的时候支付了很高的前期成本,但是在查询阶段,我们可以使用贪心算法,使用最少的gram覆盖整个查询,从而提高查询速度。那么在建立索引的时候,能不能更加高效一点?在之前的示例中,我们使用crc32作为权重函数,但只要是确定的哈希函数都可以用在这里。如果我们对非常罕见的 字符对 赋予高权重,对非常频繁的 字符对 赋予低权重,这会使得我们在查询阶段可以选出更具有区分度的子串,从而减小posting list,减少候选文档。
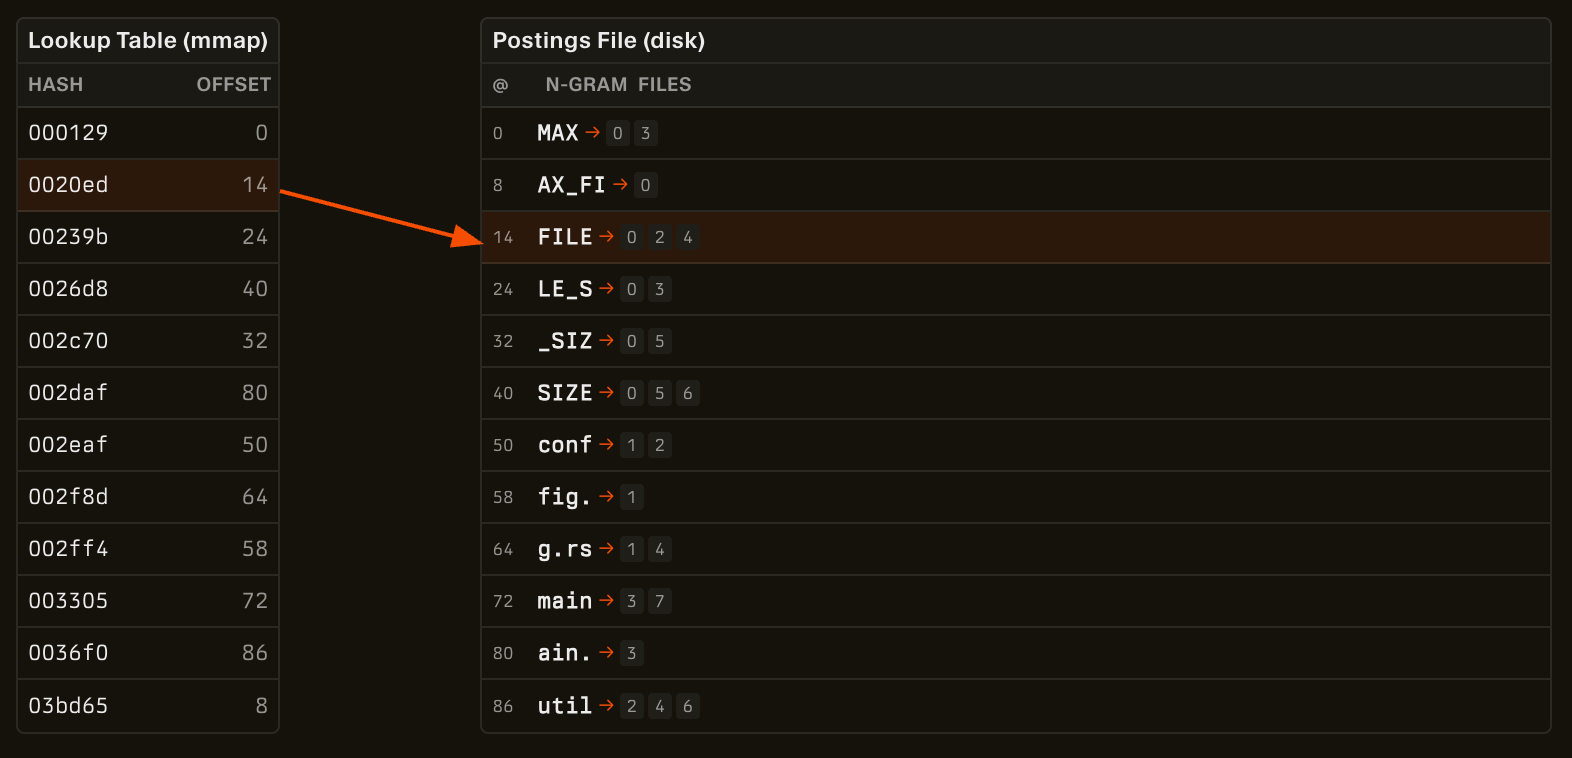
在实际工程实现中,cursor使用两个文件来存储索引。一个文件记录所有n-gram的哈希值以及对应的posting list的offset(下图左侧),另一个文件包含所有的posting list(下图右侧)。cusor使用哈希值而不是完整的ngram虽然会有极小概率发生哈希碰撞,使得posting list的结果范围更宽泛,但不会产生错误的结果。由于记录按照hash值排列存储,这个表是有序的,所以可以直接使用二分查找来处理查询,返回offset,再通过这个offset来读取postings文件的数据。
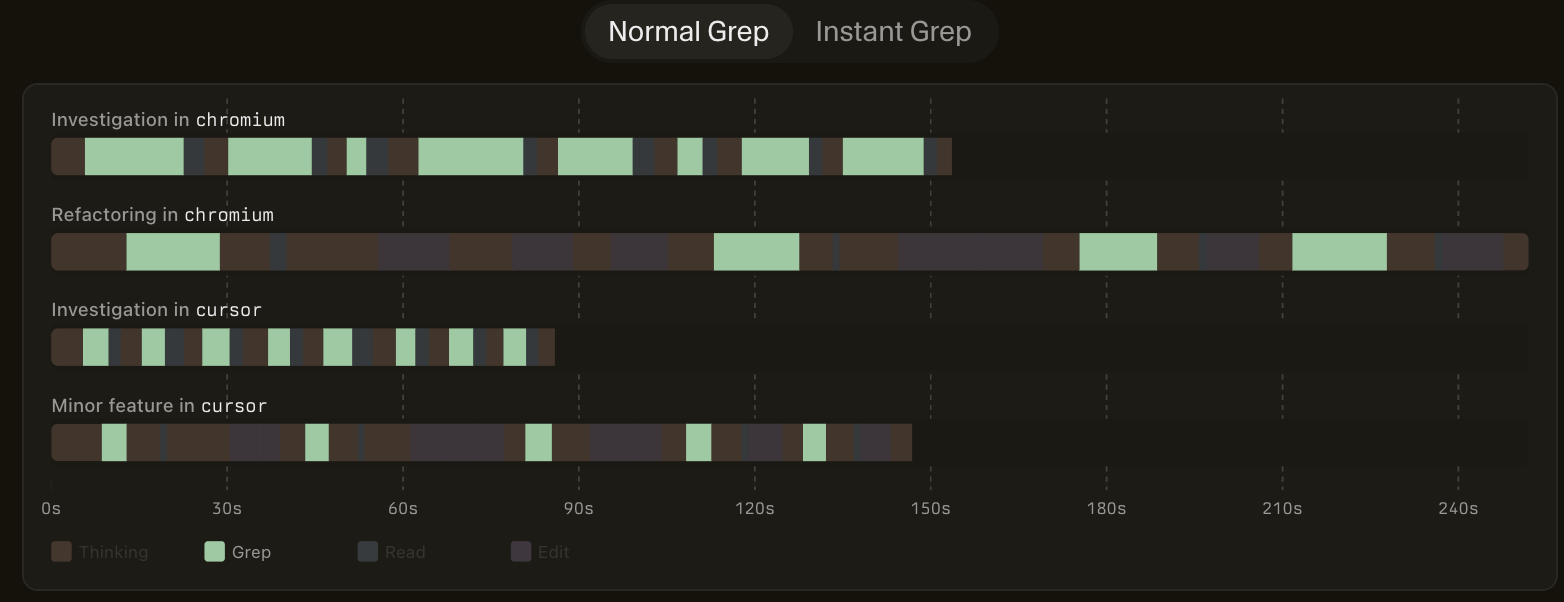
 从下图我们可以看到优化grep会带来多少性能提升:
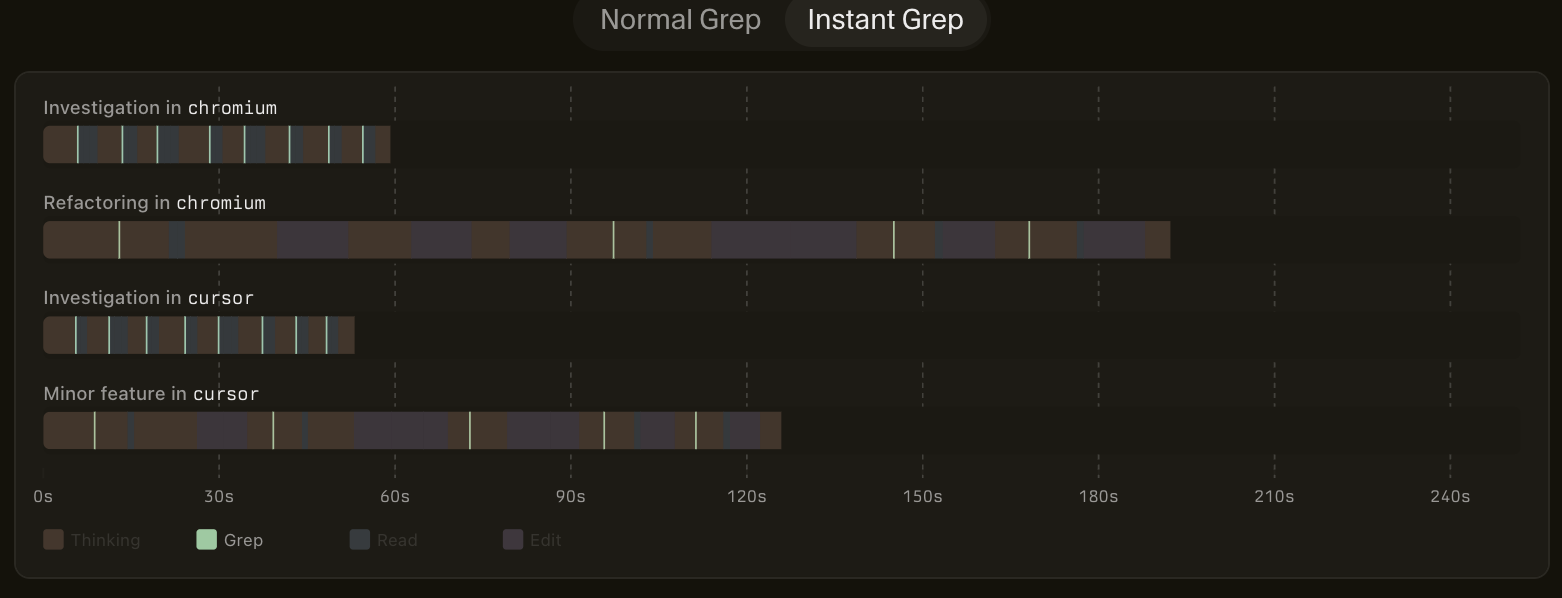 这篇博客断断续续,终于在中秋的时候完结了,关于搜索,索引,还有很多有趣的知识,在实际的应用也非常广泛,在后续的博客中我也会分享一些数据库中使用的算法,接下来我们看看cursor在rl训练上有什么insight~