原博客链接:Agent评测漫谈 —— 由浅入深讲解Agent评测 | 美团 · 技术团队
这篇博客在我的仓库吃灰很久了,隔了一个月终于翻出来了。做点简单的摘要,笔记。
开发agent评测,核心目的是为了回答agent好不好,哪里好哪里不好。而agent评测的基石是观测,在真实场景中,agent评测不只是看结果,还要看行为和过程。美团将agent评测需要覆盖的内容分为以下四层:
- 结果层:任务是否完成,输出是否可用
- 过程层:规划是否合理,步骤是否稳定
- 效率层:耗时、Token、工具调用次数是否可接受
- 风险层(安全层):是否越权、是否误操作、是否存在安全隐患
当agent能力越来越强大时,agent评测也正在从“答案评测”走向“行为评测”。
美团认为:Agent属于广义的SaaS层。用户期望得到一个稳定可靠的智能体,因此我们必须从工程的视角来看待agent。为了保证agent的输出的结果稳定,我们需要过程稳定。因此工业界发展出了“Trace"系统,将黑盒中的逻辑推理过程进行全路径的披露,将所有影响模型输出的输入信息都记录下来。从trace的角度进行观测,是实现从”概率性生成“向”工业级可靠性“跨越的必由之路。
agent实际是将强大的模型能力落地到真实到业务场景。但两侧的指标有天然的鸿沟。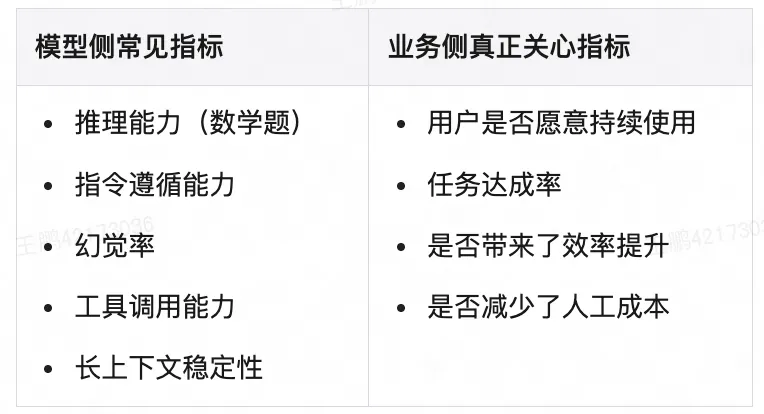 因此我们必须在中间搭起一座“桥”,也就是agent能力层。这层重点关注的是能不能把用户的任务做成,是否拥有稳定的执行能力,相关的指标如任务完成率,一次成功率,tool/skill调用成功率等等,这类的指标体系必须依赖真正懂业务流程的人构建。相信业内的朋友对这些指标会非常熟悉,摸鱼刷帖的时候仿佛回到了工作中。
行业内的agent评测分为主观和客观。现实中通常的做法是:
- 用客观评测覆盖高频、结构化、可规则化的部分
- 用主观评测覆盖开放性、高价值、复杂业务场景
- 用主观评测校准客观评测和 AI 评测,再把规模化部分交给自动化系统
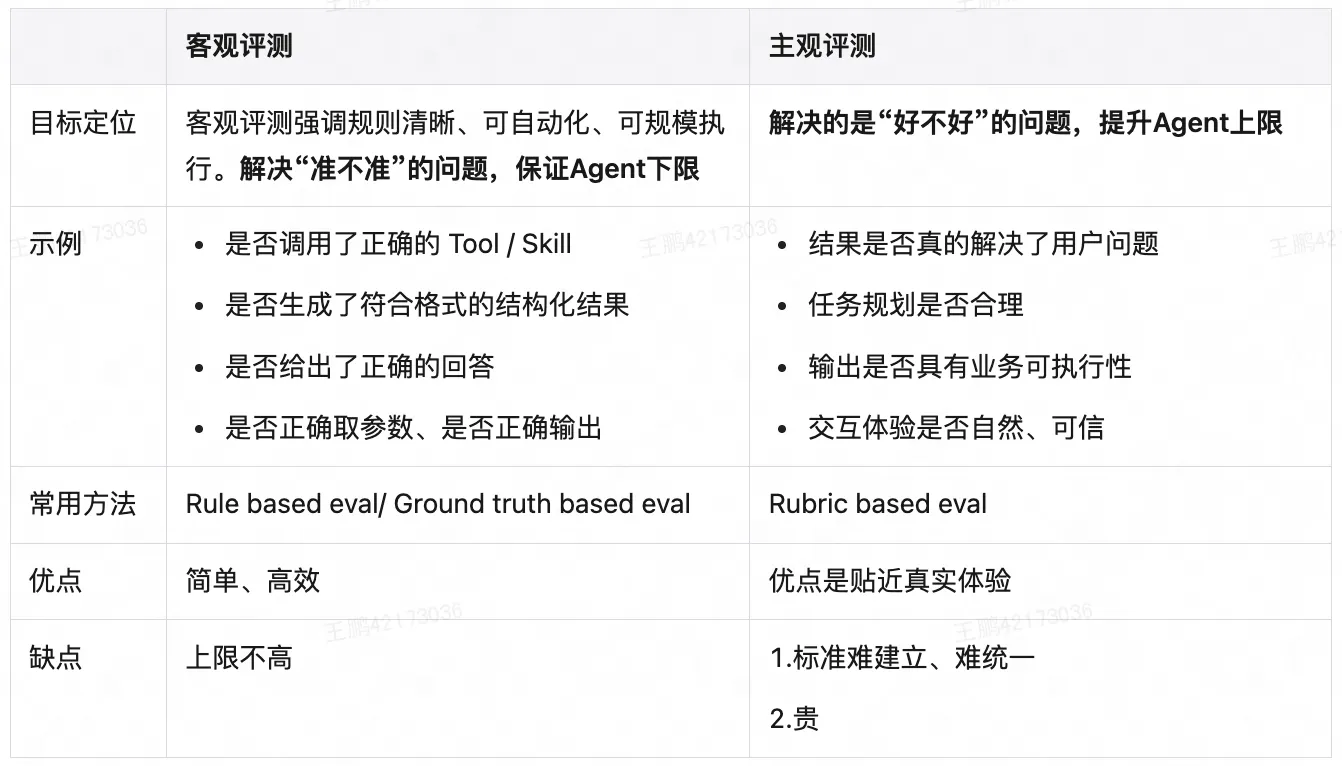 在实际的任务中,我们也确实是按照这个思路进行agent评测。文章接下来提到的人人一致,人机一致,评测rubric都是我们广泛使用的方法,在这里不再赘述。
执行链路上我们将agent评测大致分为采数据,洗数据,评测,质检,归因。
很多新手从一开始就想要设计一个复杂精妙的评测指标体系,而事实上评测体系的建立不是一蹴而就,而是靠good case和bad case喂养起来的。其中bad case的价值往往更高,因为它最能暴露agent的能力边界和系统短板。good case则是帮助团队定义高质量完成的范式。
后面的我简单读了读,没有我想要的内容,唯一值得记录的就是这幅图:
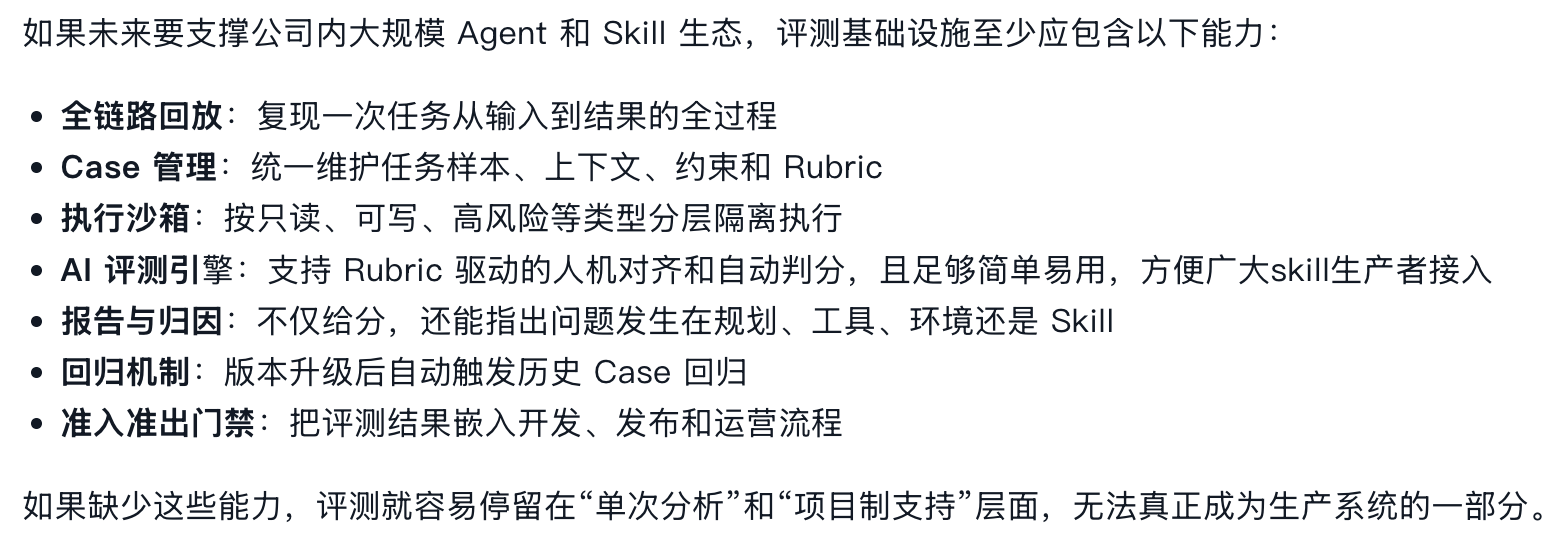 也许我们都在寻找关于trace如何评估的答案。