本文从基础原理、经典调度和工程实现出发,逐步进入 Zero Bubble、长上下文、双向流水线以及 Kimi K3 的计算—通信—卸载联合调度。
目录
10 · 长上下文 PP:从 Micro Batch 走向序列切片
专题 · Kimi K3:把计算、通信与卸载放进同一张时间表
**学习主线:**每一种方法都回答四个问题:切了什么、谁在等待、显存何时达到峰值、收益是否超过通信与调度代价。
学习路线
阶段
目标
核心内容
① 基础原理
看懂一条流水线
Stage、Micro Batch、前向/反向、点对点通信、气泡
② 经典调度
看懂时间线与显存
GPipe、1F1B、交错 1F1B、同步语义
③ 工程实现
定位真实训练瓶颈
Stage 均衡、通信重叠、拓扑放置、激活生命周期、Megatron 源码与 Profile
④ 前沿研究
理解论文创新边界
Zero Bubble、可控显存调度、长上下文、双向/异步流水线、自动调度搜索
1 · PP 到底切了什么
先建立一个最重要的边界:PP(Pipeline Parallelism,流水线并行)切的是连续层或模型块,不负责切开单层矩阵。图中用 12 层、4 个 Stage 展示模型如何常驻到不同 GPU。
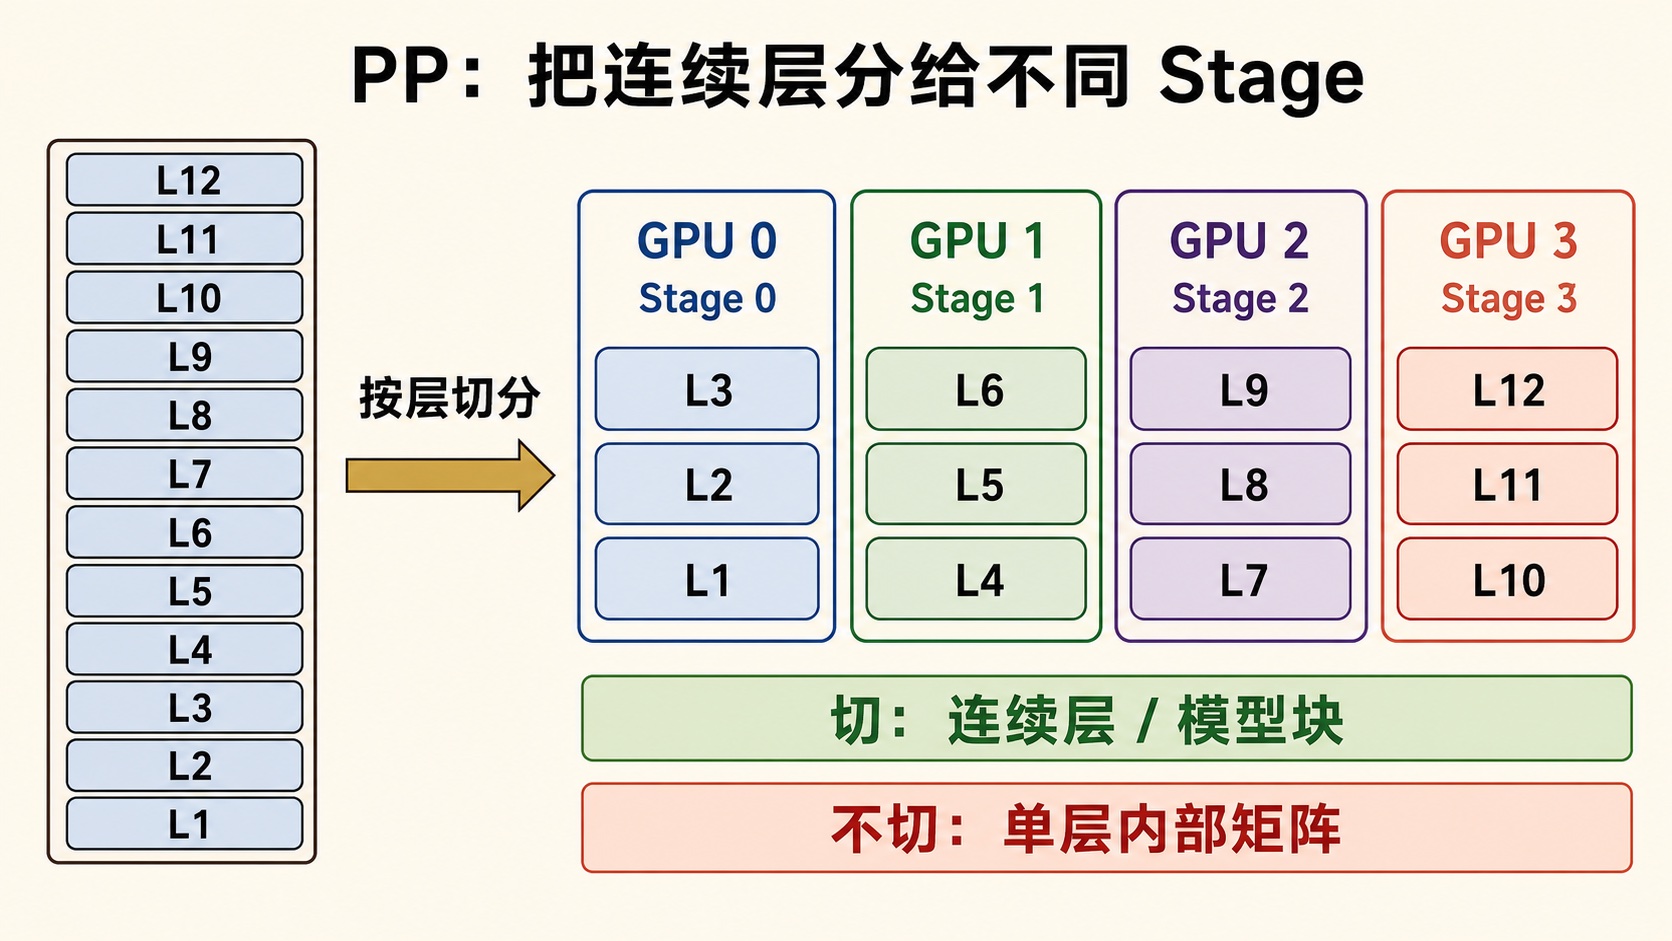
图 1|PP 切连续层,不切单层矩阵
PP 按层或模型块切分网络,把连续的层分配给不同 Pipeline Stage(流水线阶段)。每个 Stage 只保存并计算自己负责的层;相邻 Stage 之间传递激活值,反向时再传递激活梯度。
**切了:**层和模型块。**没有切:**单层内部的权重矩阵;单层矩阵通常由 TP(Tensor Parallelism,张量并行)继续切分。
2 · 一次训练怎样穿过多个 Stage
一次训练同时存在两条相反的数据流:前向发送激活,反向发送激活梯度;它们都是相邻 Stage 之间的 P2P(Point-to-Point,点对点)Send/Recv。
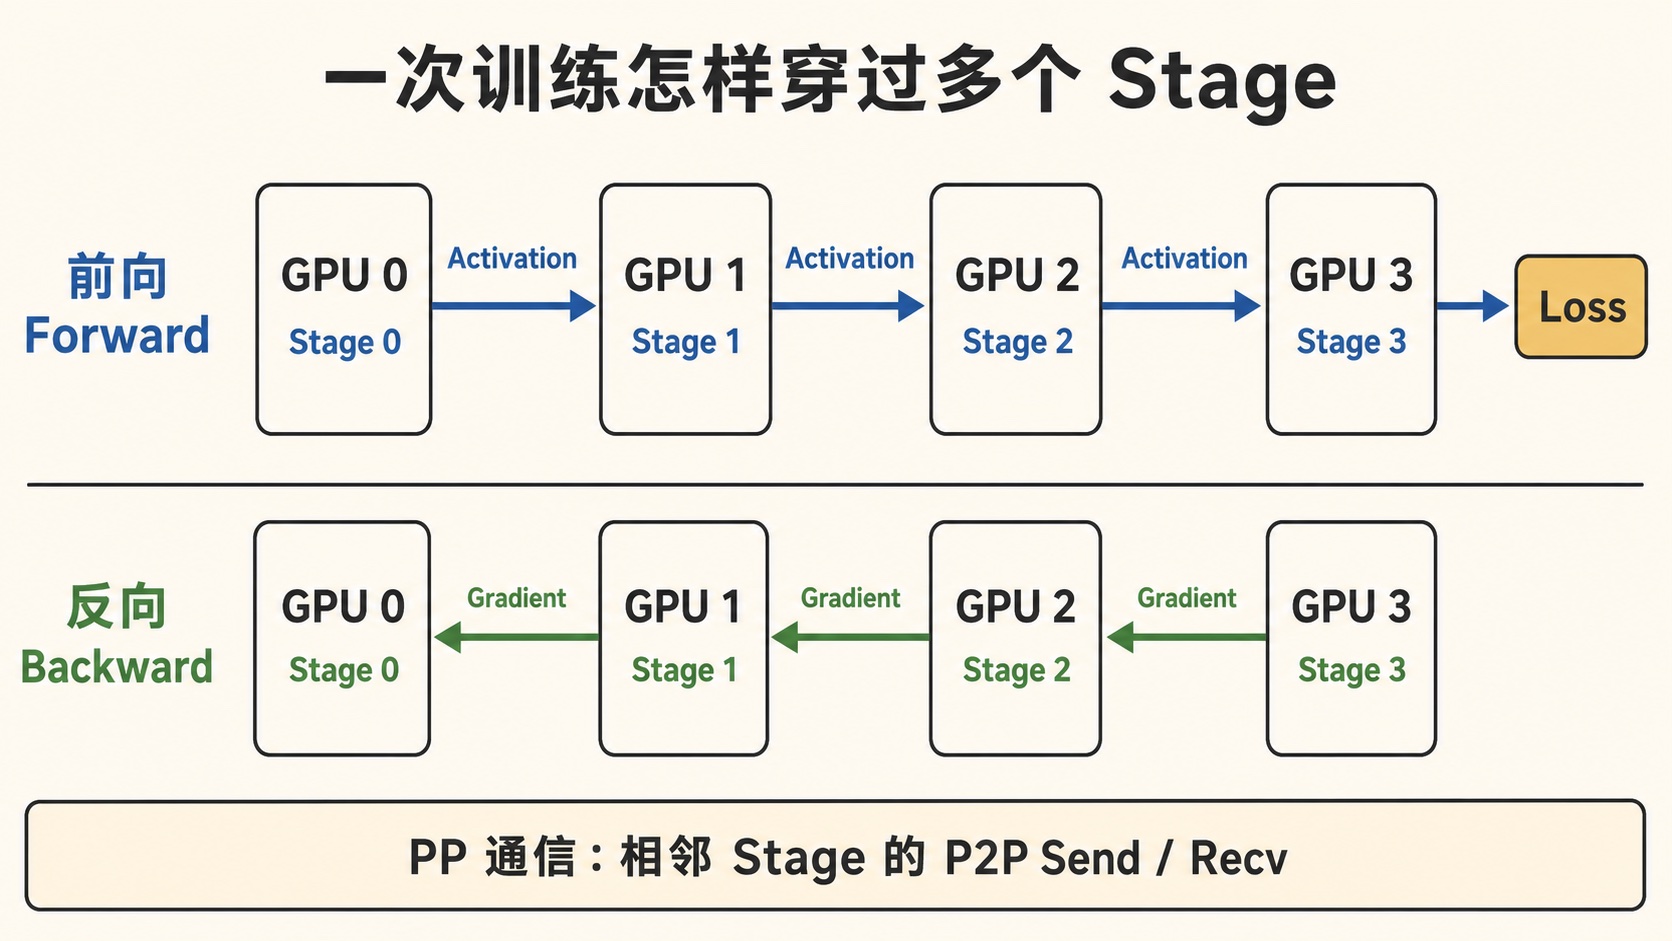
图 2|前向激活与反向激活梯度的 P2P 流动
前向传播从 Stage 0 开始:Stage 0 计算局部层并把激活发送给 Stage 1,直到最后一个 Stage 计算 Loss。反向传播方向相反:最后一个 Stage 先计算梯度,再把输入梯度逐级传回前一个 Stage。
PP 的主要通信是相邻 Stage 之间的 P2P(Point-to-Point,点对点)Send/Recv。发送的是激活或激活梯度,通信量受 Micro Batch、序列长度、隐藏维度和数据类型影响。
3 · 为什么要使用 Micro Batch
把完整 Batch 拆成多个 Micro Batch 后,后续 Stage 不必等整批完成;它可以在前一个 Stage 处理下一小批时,继续计算上一小批。
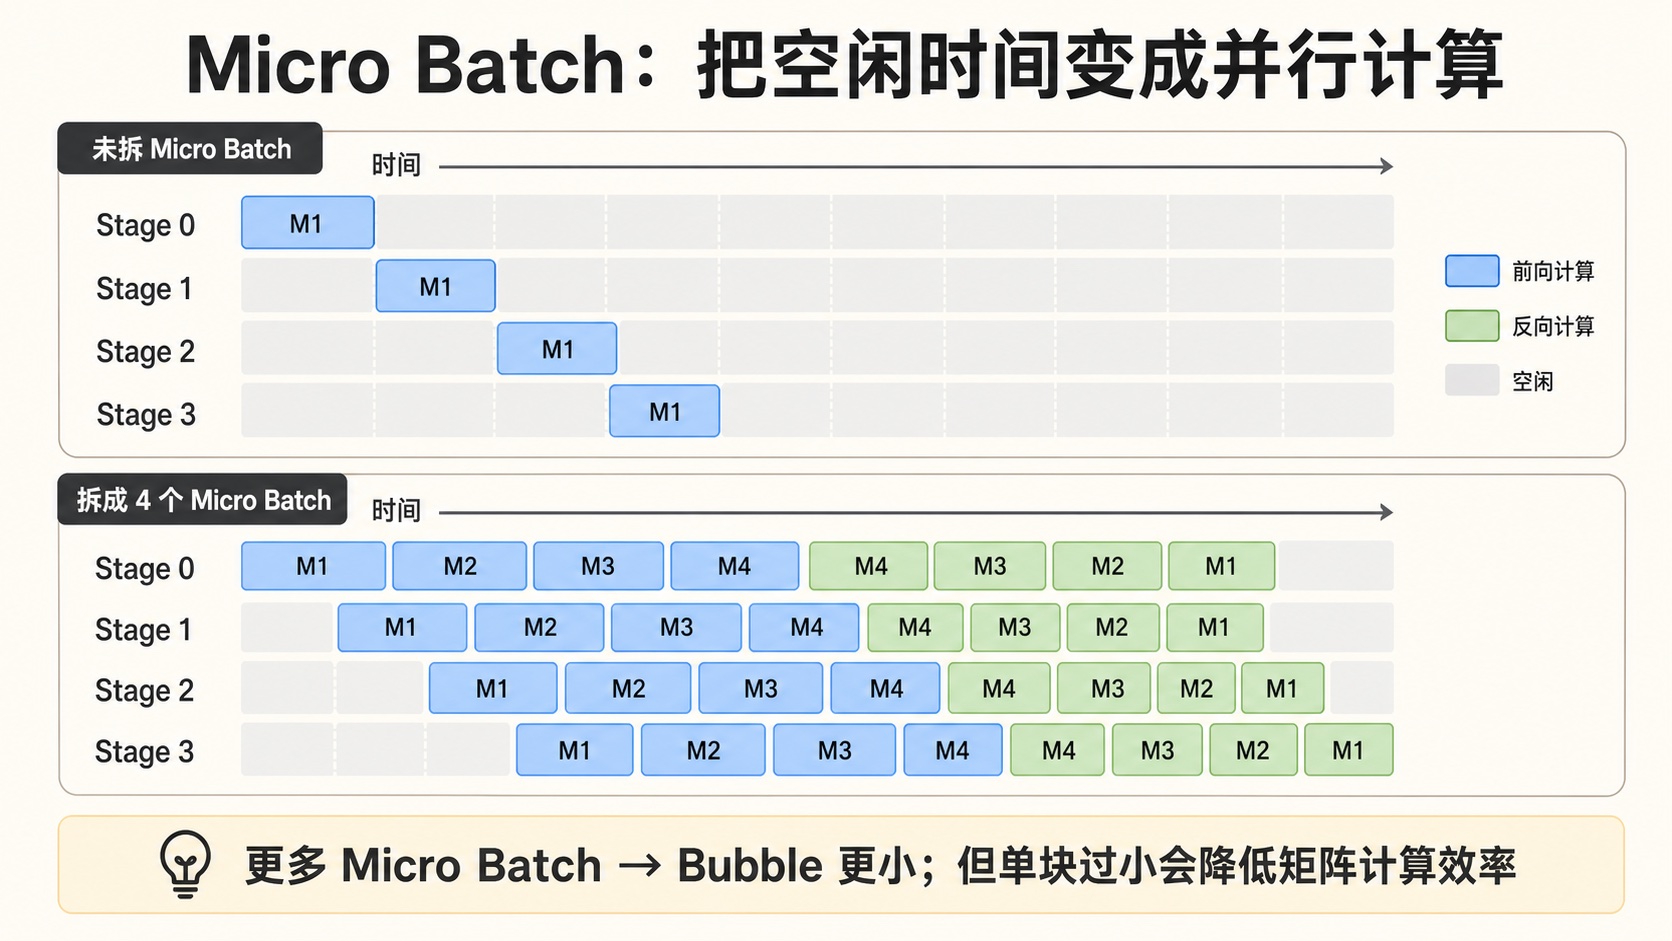
图 3|Micro Batch 如何缩小流水线空泡
如果把一个完整 Batch 一次送入流水线,后面的 Stage 必须等待前面的 Stage 完成,GPU 大量空闲。把 Batch 拆成多个 Micro Batch 后,不同 Stage 可以同时处理不同 Micro Batch,让流水线持续有工作。
**但 Micro Batch 不是越多越好。**单个 Micro Batch 太小时,GEMM 规模减小,Tensor Core 利用率可能下降;Kernel Launch 与 Send/Recv 的固定开销占比也会上升。
4 · Pipeline Bubble 怎样计算
Bubble(流水线空泡)是 Stage 因依赖尚未满足而空闲的时间。理想化同步流水线中,阶段数越多、Micro Batch 越少,Bubble 占比越高。
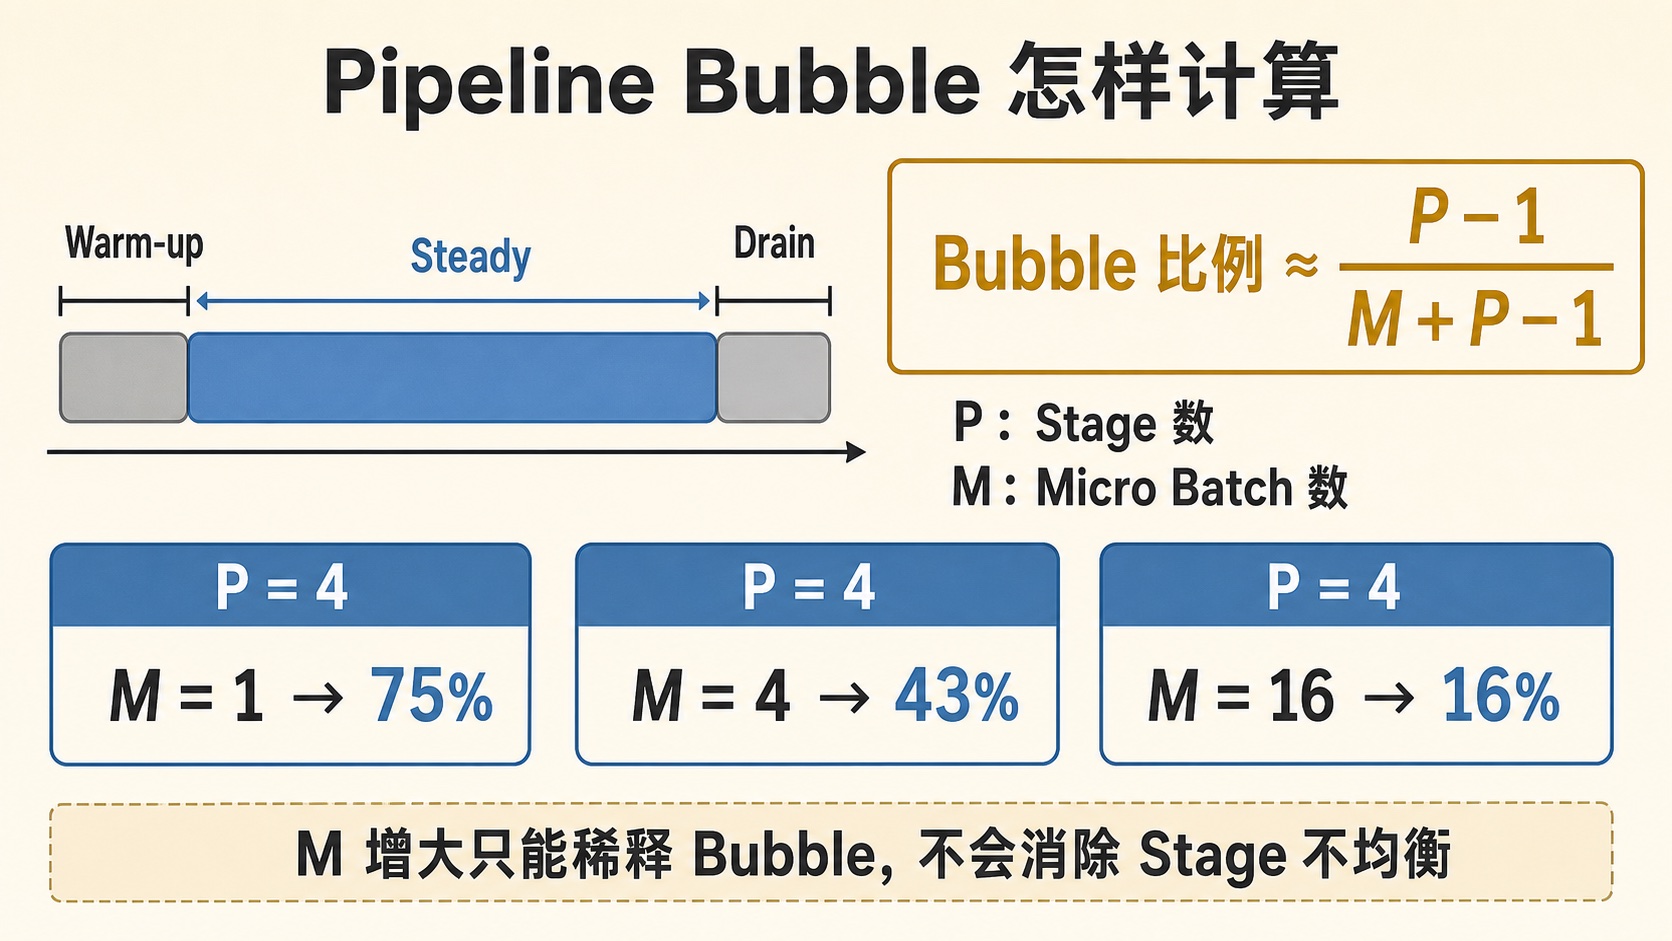
图 4|Bubble 的来源与理想化比例
Pipeline Bubble(流水线气泡)是某些 Stage 因等待输入、等待梯度或流水线启动与排空而空闲的时间。
在 Stage 耗时相同、使用 GPipe 调度的简化假设下:
[Bubble\ Ratio \approx \frac{K-1}{M+K-1}]
K 是 Stage 数,M 是 Micro Batch 数。K=4、M=4 时气泡占比约为 42.9%;K=4、M=16 时约为 15.8%。增加 M 可以摊薄启动和排空成本,但无法消除 Stage 不均衡或暴露通信。
5 · 经典调度:GPipe、1F1B 与 VPP
经典调度的核心差别不在模型切法,而在前向与反向的先后顺序。GPipe、1F1B(One Forward One Backward,一次前向一次反向)和 VPP(Virtual Pipeline Parallelism,虚拟流水线并行)在 Bubble、激活峰值与调度复杂度之间取不同平衡。
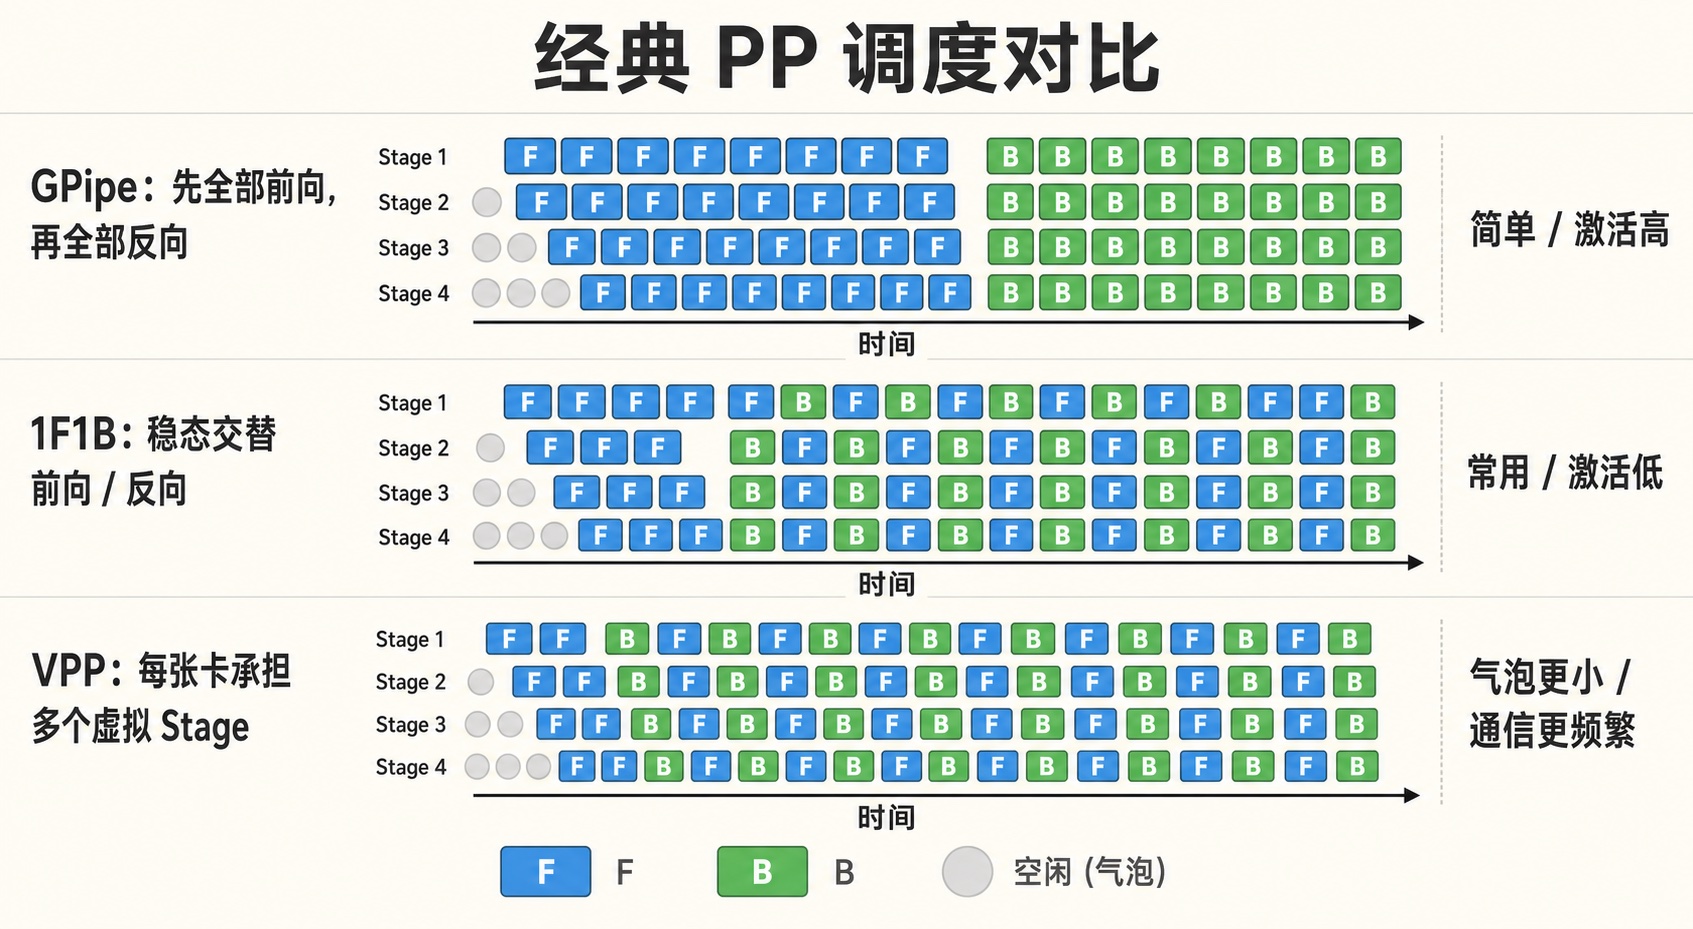
图 5|GPipe、1F1B 与 VPP 的调度差异
调度还会改变激活的驻留时间。反向开始得越早,前向保存的激活就能越早释放,因此 1F1B 通常比 GPipe 需要更低的激活峰值。
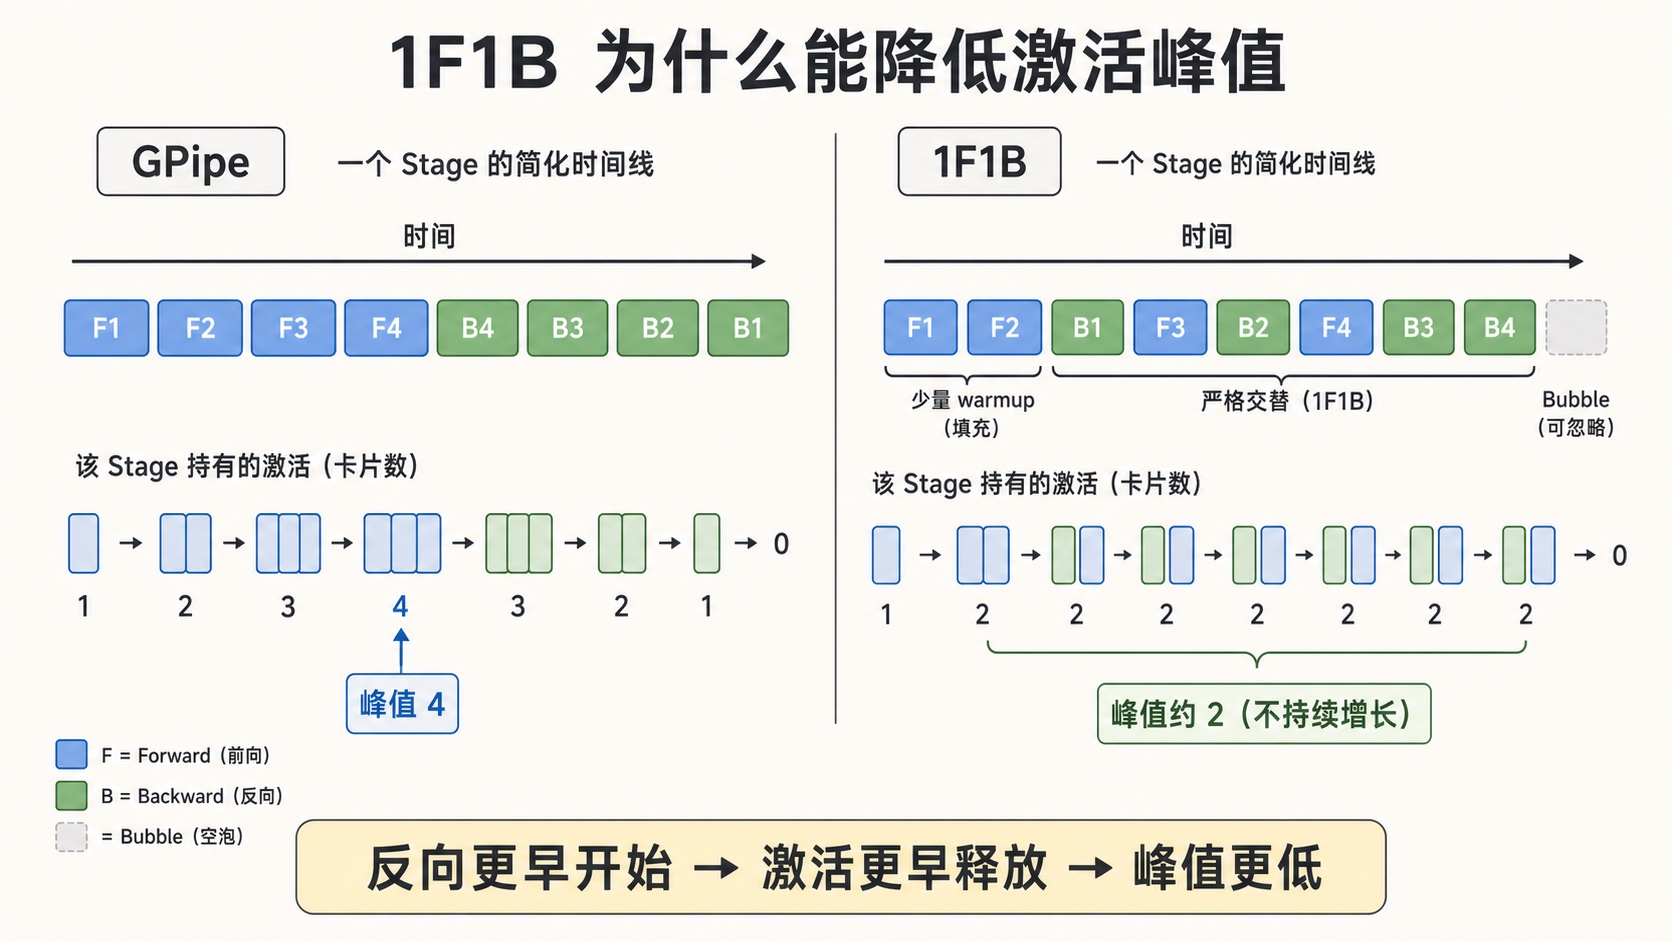
图 6|GPipe 与 1F1B 的激活峰值差异
1F1B(One Forward One Backward,一次前向一次反向)和 VPP(Virtual Pipeline Parallelism,虚拟流水线并行)是理解后续前沿调度的基础。
调度
执行顺序
主要作用
GPipe
先完成所有 Micro Batch 的前向,再统一执行反向
直观,但需要保留较多激活
1F1B
预热后交替执行一次前向和一次反向
更早释放激活,主要降低显存峰值
Interleaved 1F1B / VPP
一张 GPU 负责多个不连续的虚拟 Stage
减少空闲区间,但增加通信频率与调度复杂度
6 · 工程上怎样继续优化
真实瓶颈常来自 Stage 不均衡:层数相等并不代表耗时相等,最慢 Stage 会把其他 Stage 变成等待者,因此切层必须以 Profile 的前向与反向耗时为依据。
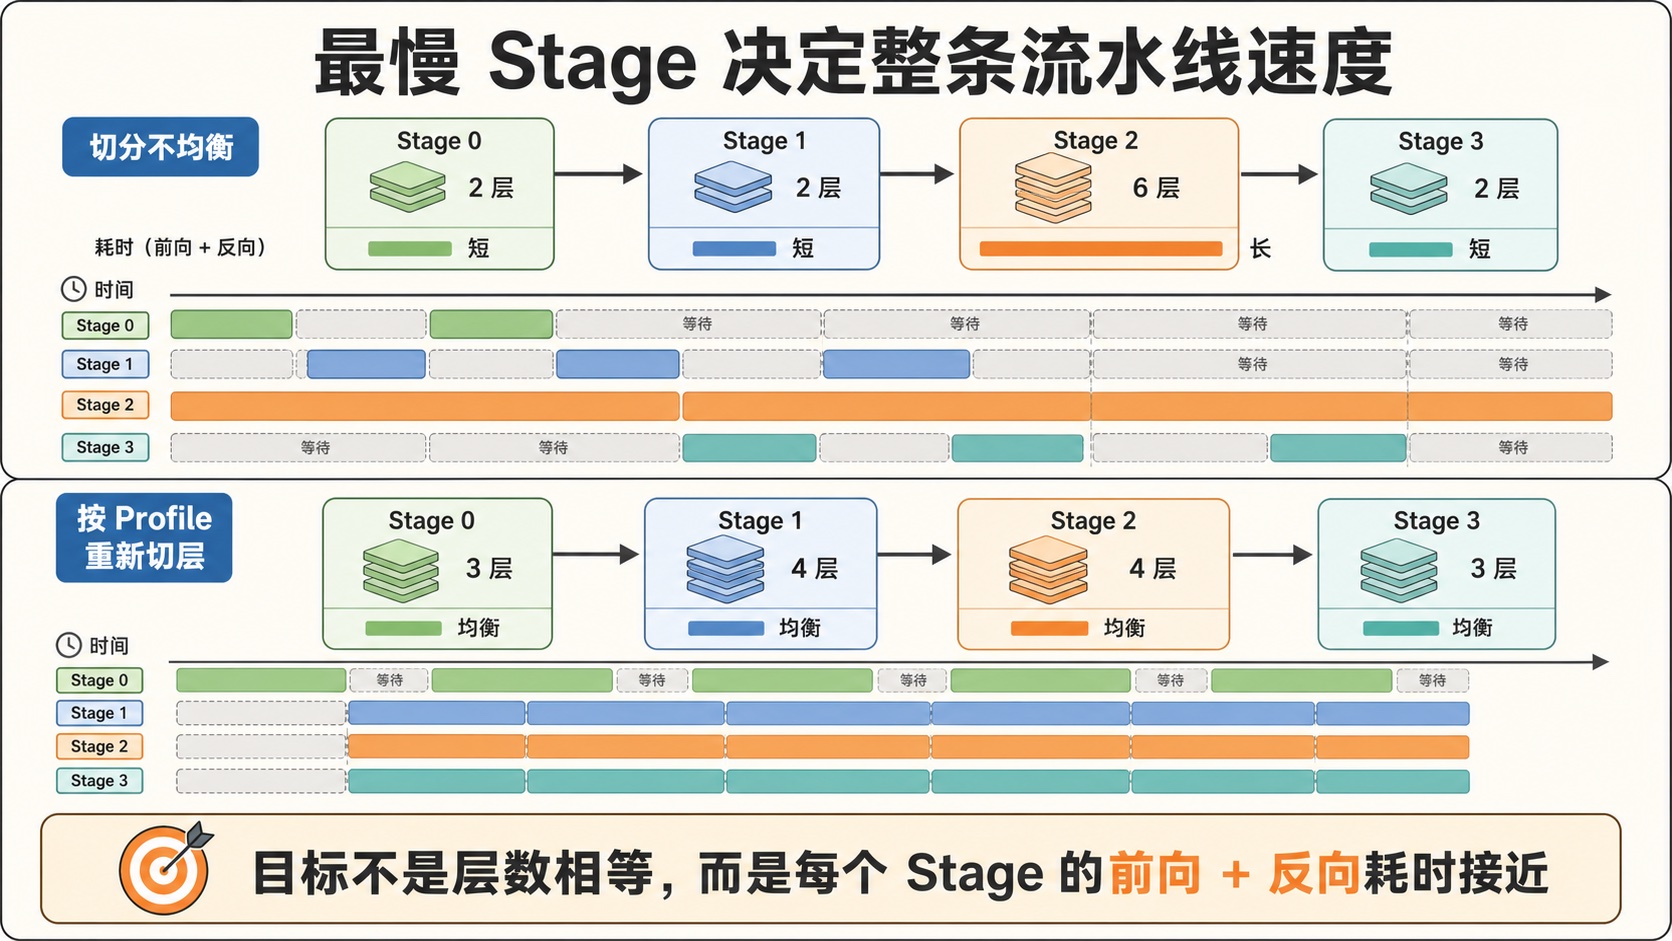
图 7|最慢 Stage 与按 Profile 重切层
即使通信量不变,也可以通过 Prefetch(预取)和 Overlap(重叠)缩短暴露在关键路径上的通信时间;前提是计算流与通信流能够并发,且拓扑和带宽允许。
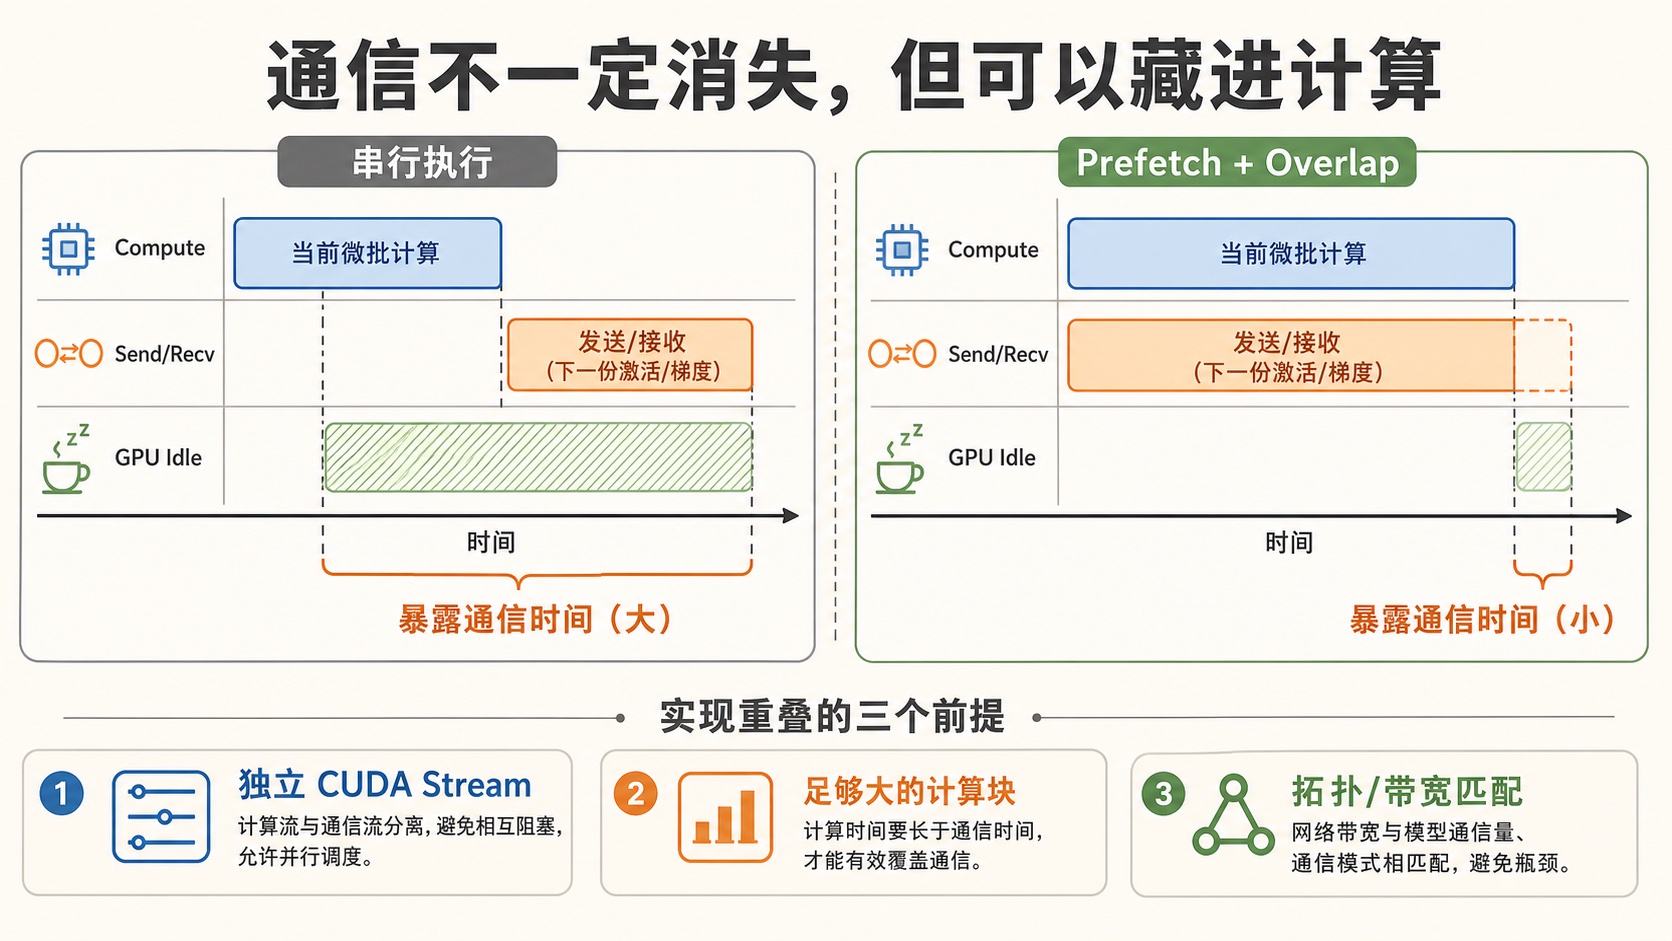
图 8|计算与通信重叠
**Stage 重平衡。**按前向、反向的实际耗时切层,不要只按层数平均。Embedding、Loss、MoE 和不同 Transformer 层可能耗时不同,最慢 Stage 决定整体节拍。
**通信计算重叠。**异步执行相邻 Stage 的 Send/Recv,把可以重叠的通信隐藏在 GEMM 后面。
**拓扑感知放置。**高频通信的相邻 Stage 应优先放在同机或更快链路,避免跨 NUMA、跨机路径放大通信时间。
**控制激活生命周期。**1F1B、Activation Checkpointing 和 Offload 可以降低峰值或容纳更多在途 Micro Batch,但重计算和传输也可能增加 Step Time。
7 · 实际训练应该观察什么
定位 PP 瓶颈时,不应只看聚合 GPU 利用率。先比较每个 Stage 的前向与反向耗时,再看 P2P 暴露通信和 Bubble,最后用端到端 loss tokens/s 验收。
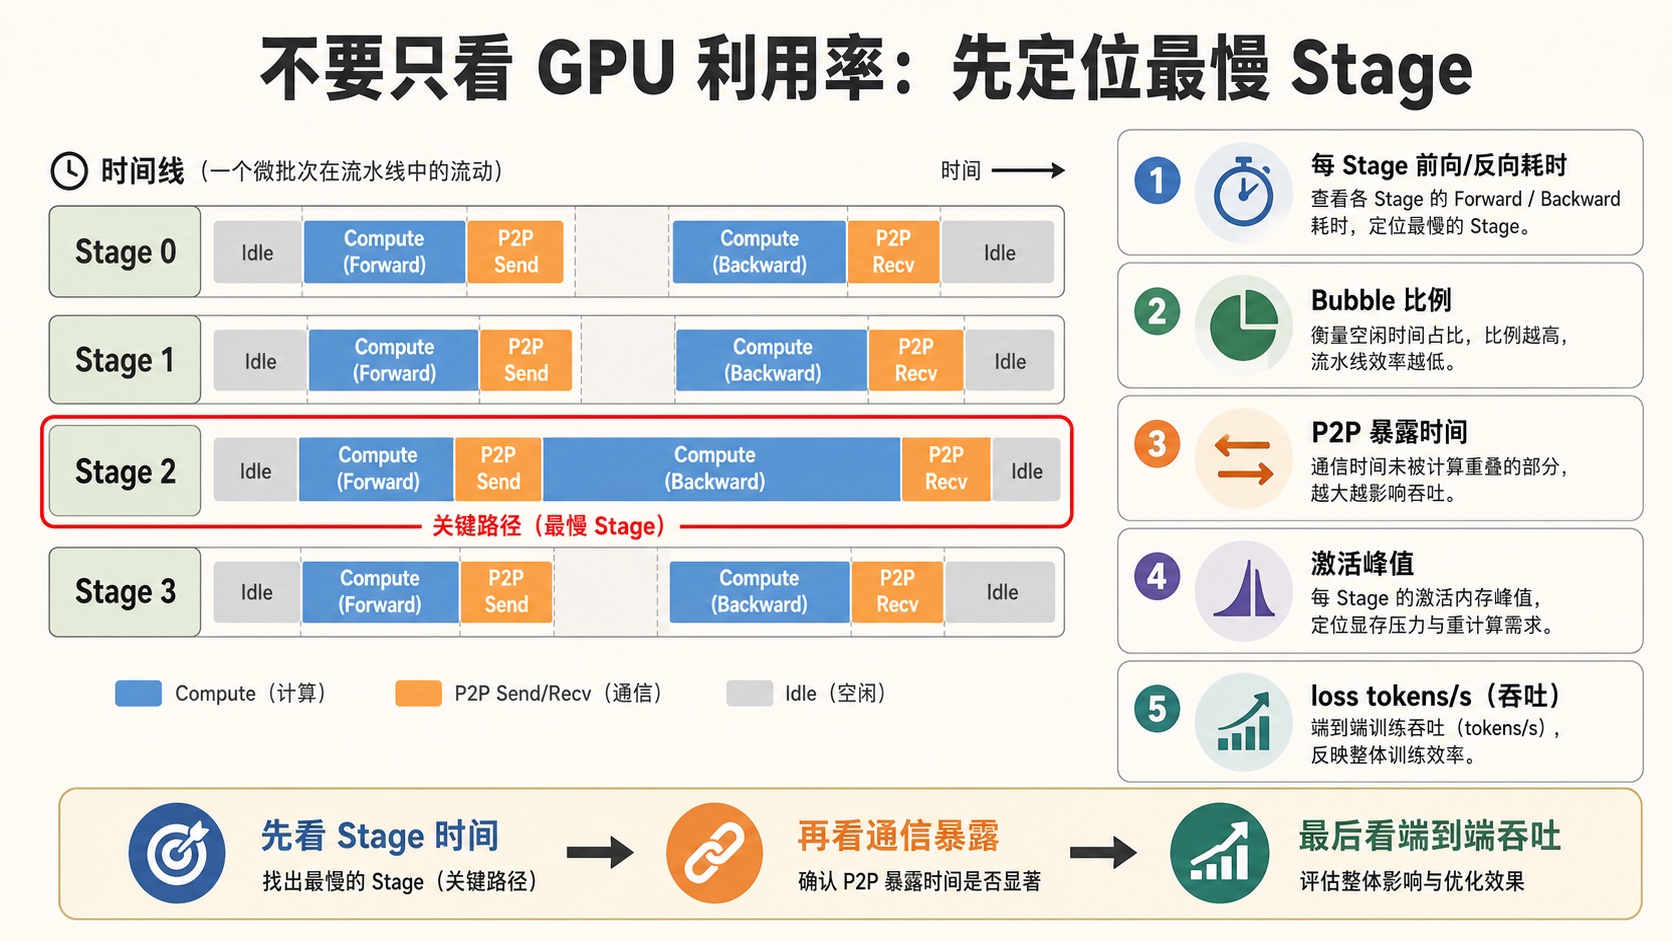
图 9|PP 瓶颈诊断顺序
现象
可能原因
优先检查
固定 Stage 总是最慢
层切分不均或该 Stage 包含额外计算
per-stage 前向/反向耗时
周期性大段空闲
启动、排空气泡或 Micro Batch 数不足
调度时间线
计算之间夹着长通信
P2P 未重叠或链路过慢
NCCL Send/Recv 与拓扑
显存峰值过高
在途 Micro Batch 激活过多
1F1B、重计算、激活生命周期
8 · 从经典 PP 走向前沿
前沿 PP 不是简单增加 Micro Batch,而是在“依赖关系、显存上限、链路速度和收敛语义”共同约束下重新安排任务。
要解决的问题
代表方法
核心变化
学习定位
同步气泡仍然过大
Zero Bubble
拆分反向的输入梯度与参数梯度
重点
显存与吞吐难兼顾
Controllable Memory
用调度积木控制在途激活数量
重点
长上下文 Stage 不均
Seq1F1B、SlimPipe
从 Micro Batch 级调度扩展到序列切片
重点
单向流水线利用不足
Chimera、DualPipe
让两个方向的流水相互填补空闲
进阶
人工调度难适配异构环境
OptPipe 等自动搜索
把时间、显存、卸载和依赖转成约束优化
研究中
同步边界限制扩展
异步 PP、AMDP
以梯度延迟换取更少等待
2026 前沿
9 · Zero Bubble:为什么要拆开反向
Zero Bubble Pipeline Parallelism(零空泡流水线并行)的关键不是减少反向计算量,而是把反向拆成输入梯度 dX 与参数梯度 dW:先推进处在关键路径上的 dX,再用可延后的 dW 填补空闲。
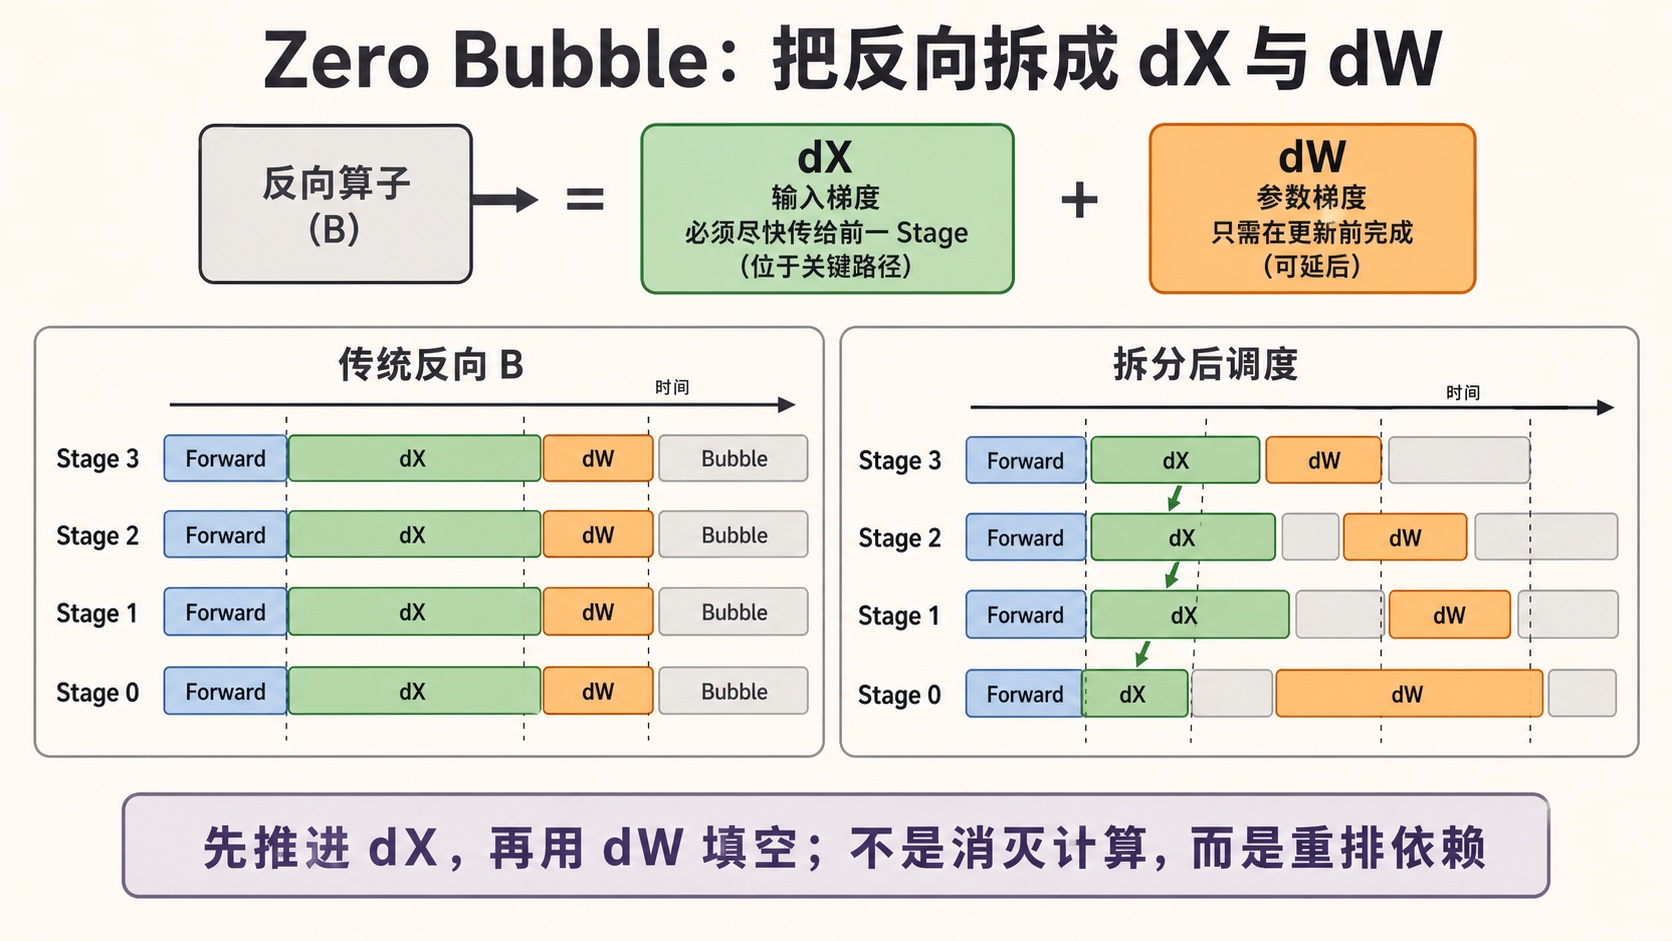
图 10|Zero Bubble 的 dX/dW 拆分
传统调度把一次反向看成一个整体。Zero Bubble(零气泡)把它拆成两类任务:输入梯度 dX 和参数梯度 dW。
**dX 在关键路径上:**前一个 Stage 必须拿到 dX 才能继续反向。**dW 通常更灵活:**它只负责本 Stage 参数更新,可以被移动到原本空闲的时间槽。
因此核心不是“反向更快”,而是先执行会阻塞其他 Stage 的 dX,再用 dW 填补气泡。理解 1F1B 后,再学习这一拆分最自然。
10 · 长上下文 PP:从 Micro Batch 走向序列切片
长上下文会让单个 Micro Batch 仍然过重。Seq1F1B 与 SlimPipe 进一步沿序列维切分工作单元,并针对因果 Attention 后段计算更重的特点按计算量均衡切片。
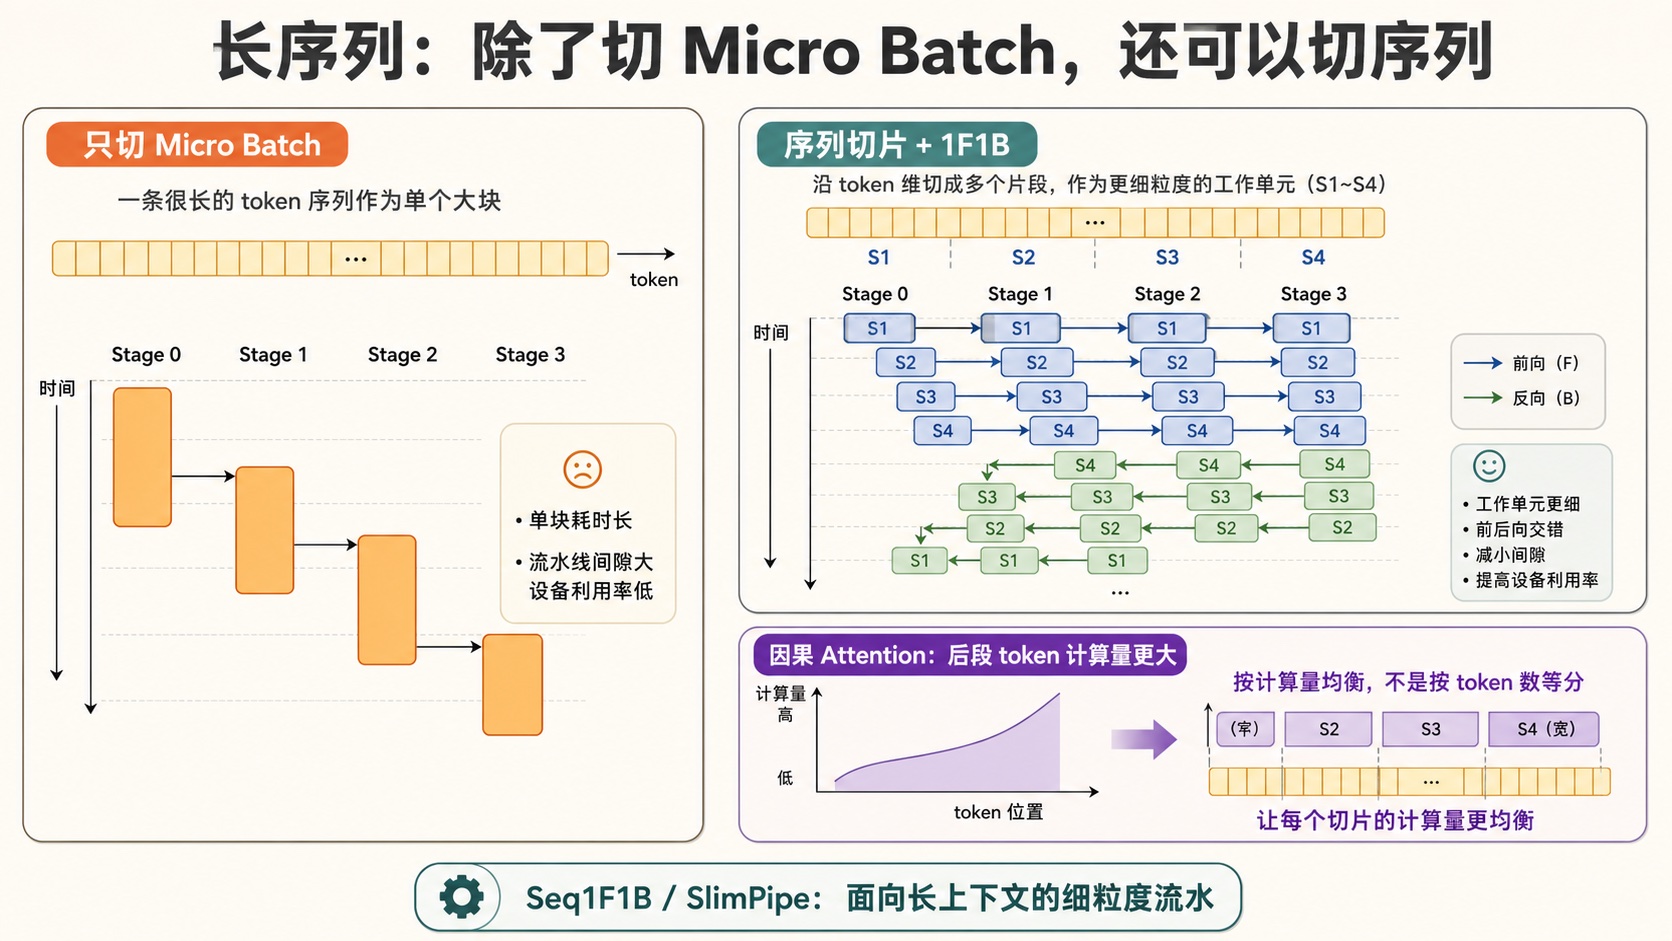
图 11|长上下文的序列切片流水
长上下文训练中,即使各 Stage 层数相同,Attention 的因果计算量也可能随序列位置变化。平均切 Token 数,不等于平均切计算量。
Seq1F1B 和 SlimPipe 把调度粒度推进到序列片段:同一个序列被切成更细的工作单元,再依据依赖和计算量穿过流水线。目标是同时降低激活显存、长上下文负载不均和流水线气泡。
11 · 双向与异步 PP
双向流水线让两条独立工作流从模型两端进入,以相反方向的工作填补彼此的空闲。它不是让同一张量向两边传播,而是用更复杂的调度、通信与状态管理换取更小的 Bubble。
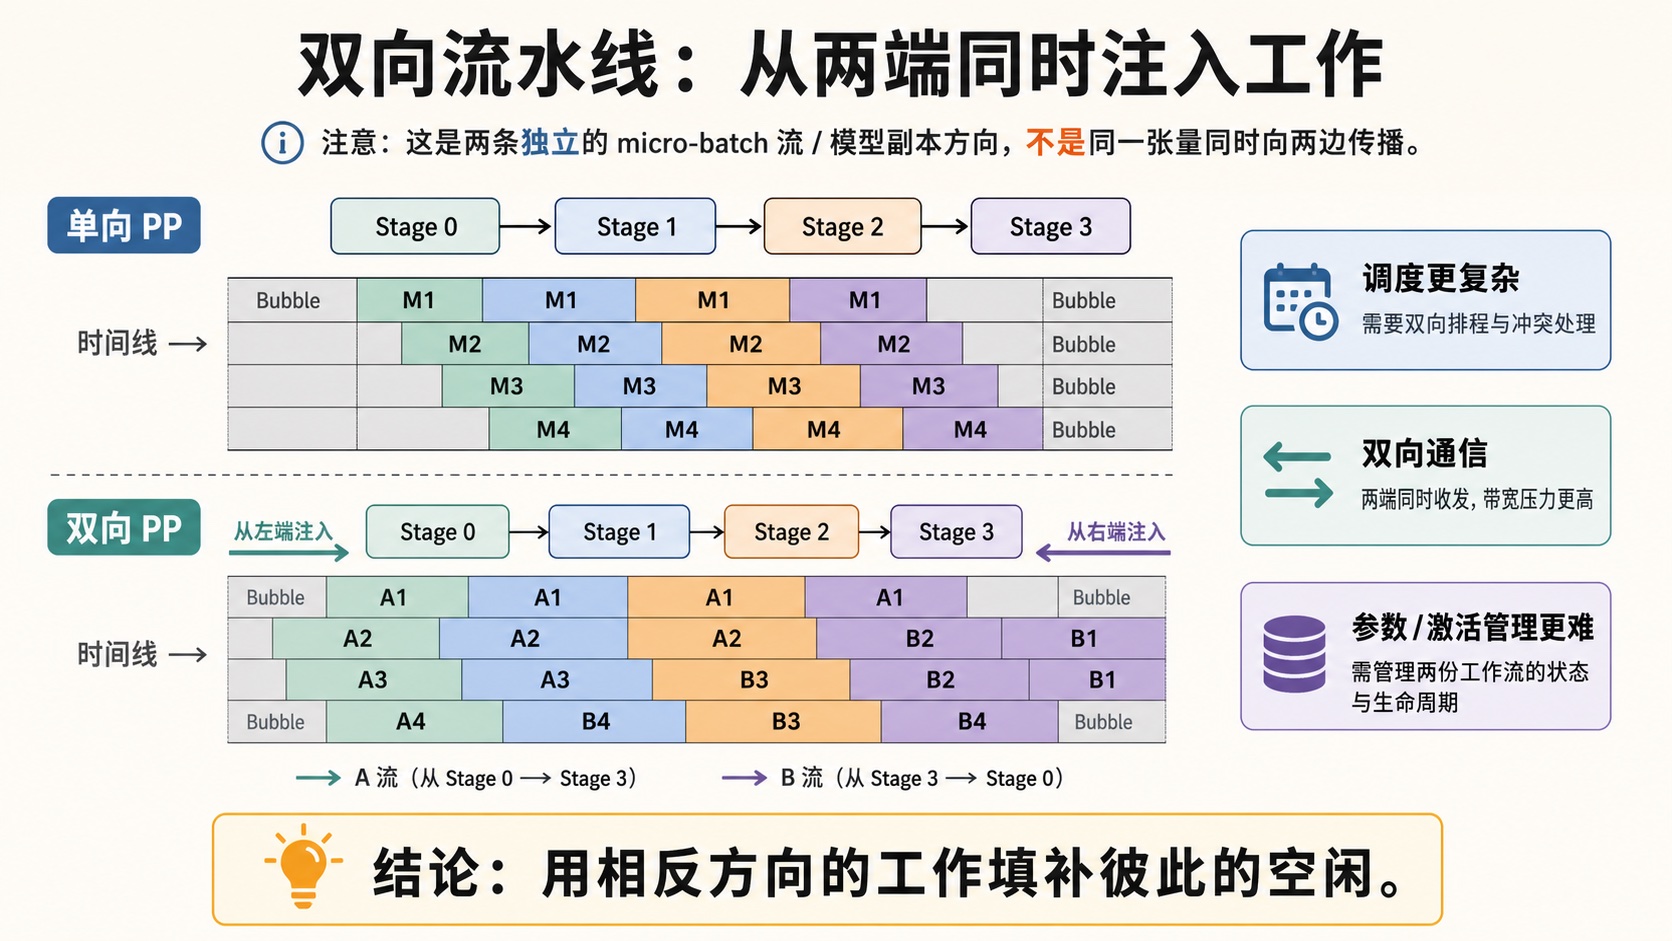
图 12|双向流水线的基本思想
**双向流水线:**Chimera、DualPipe 让不同 Micro Batch 从相反方向进入设备布局,用一条流水的空闲区间承接另一条流水的计算。
**异步流水线:**进一步放松“所有 Stage 使用同一时刻参数”的同步约束,可以减少等待,但会引入权重陈旧、梯度延迟与收敛风险。2026 年的研究正在重新评估一步梯度延迟是否能够稳定用于大模型预训练。
异步 PP 和自动调度中的部分工作仍是预印本、投稿中或已撤稿版本。这里学习其问题建模与调度思想,不把实验结论直接当成生产默认值。
12 · 自动调度与组合并行
更一般的 PP 调度可以写成约束优化:任务必须满足前后依赖;任一时刻不能超过显存上限;通信时间取决于拓扑;目标是最小化 Step Time 或最大化有效 Token 吞吐。
真实大模型通常还会组合 DP、TP、CP、EP 与 PP。学习前沿 PP 时,必须区分“调度本身的收益”和“组合并行、Kernel、拓扑带来的收益”。
专题 · Kimi K3:把计算、通信与卸载放进同一张时间表
Kimi K3 技术报告的重点不是单独提出一种孤立的 PP 调度,而是把计算、EP Communication(Expert Parallel Communication,专家并行通信)、NCCL 集合通信、本地激活卸载与远端激活卸载放在同一条时间线上联合安排。先用五条泳道读懂原图。
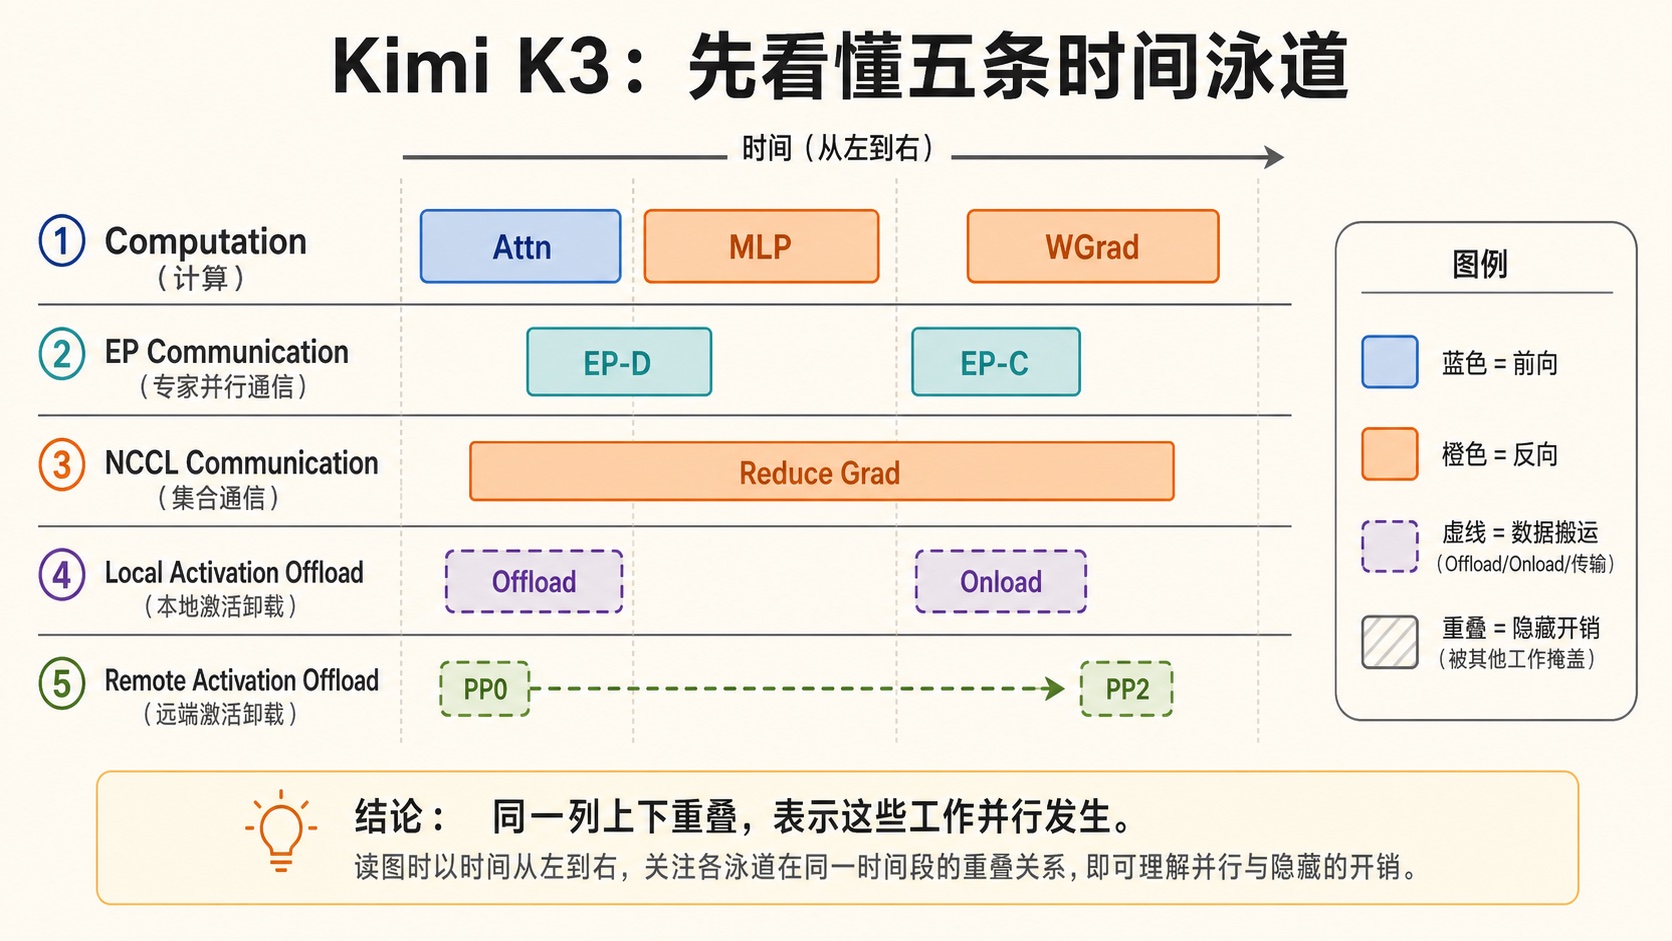
图 13|Kimi K3 Figure 11 的五条时间泳道
稳定训练阶段中,Attention、Shared Expert、MLP 与 WGrad 计算会与 EP-D、EP-C、EP-DR 等专家通信以及梯度归并交错。这里应关注整张时间表,而不是只优化某一个 Kernel。
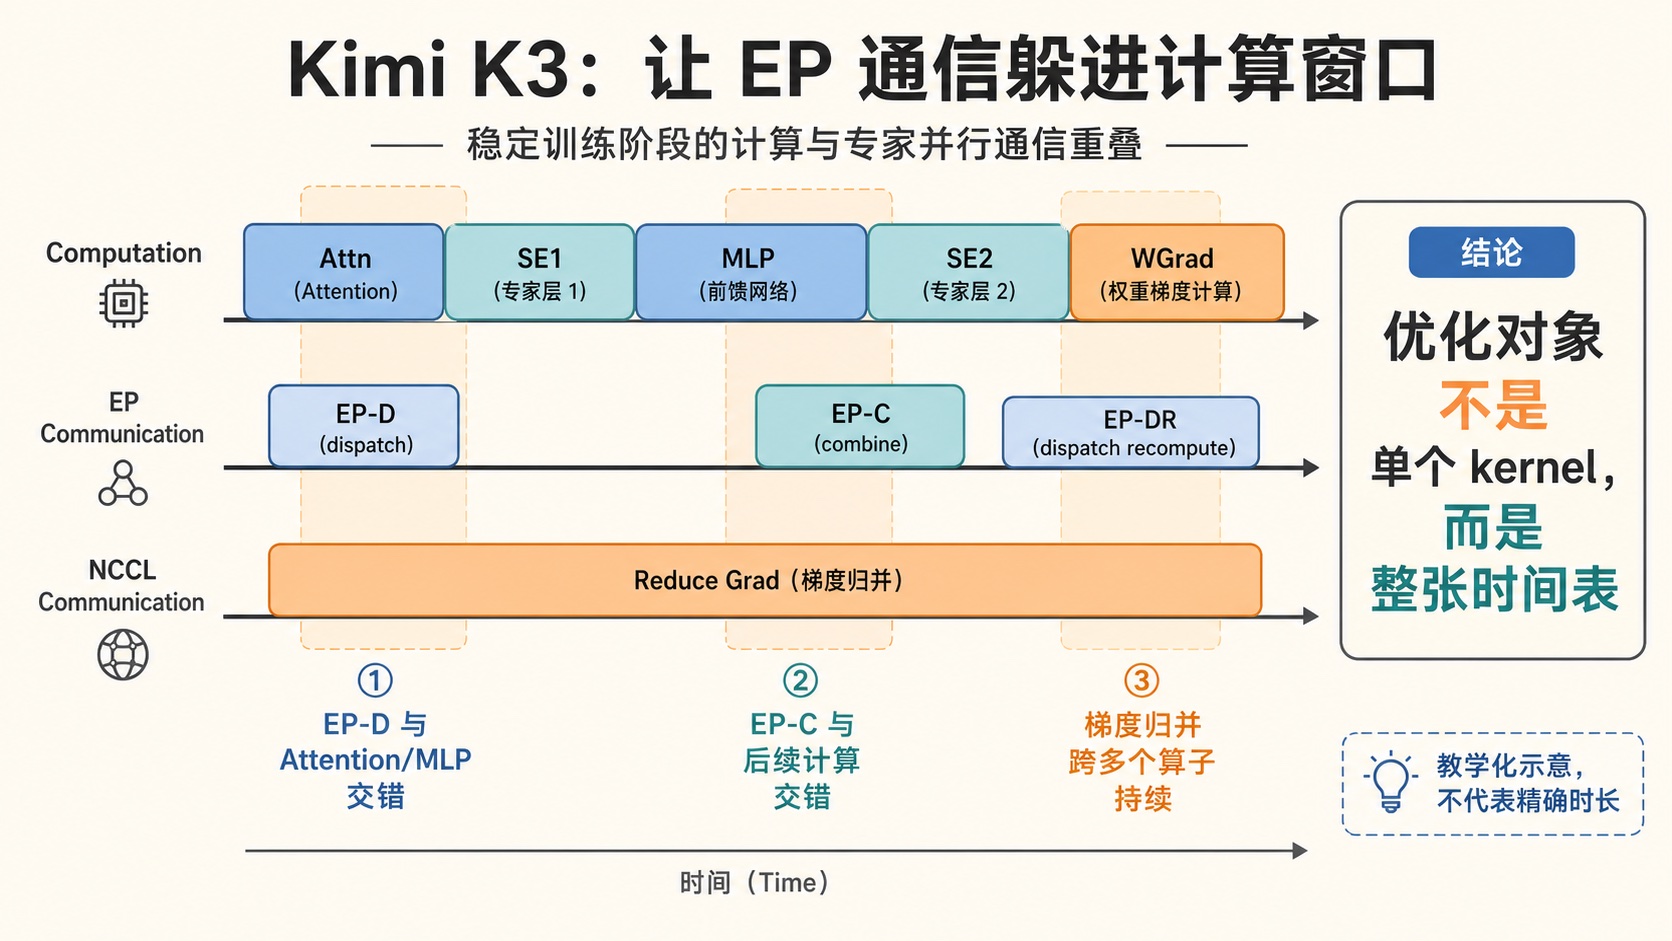
图 14|Kimi K3 稳定阶段的计算与 EP 通信重叠
显存管理也进入流水线:激活可以 Offload/Onload,梯度通过 Reduce-Scatter 分片并结合 Onload、Add、Offload 完成累加。代价是更多数据搬运,收益是降低常驻显存,并尽量用重叠保住吞吐。
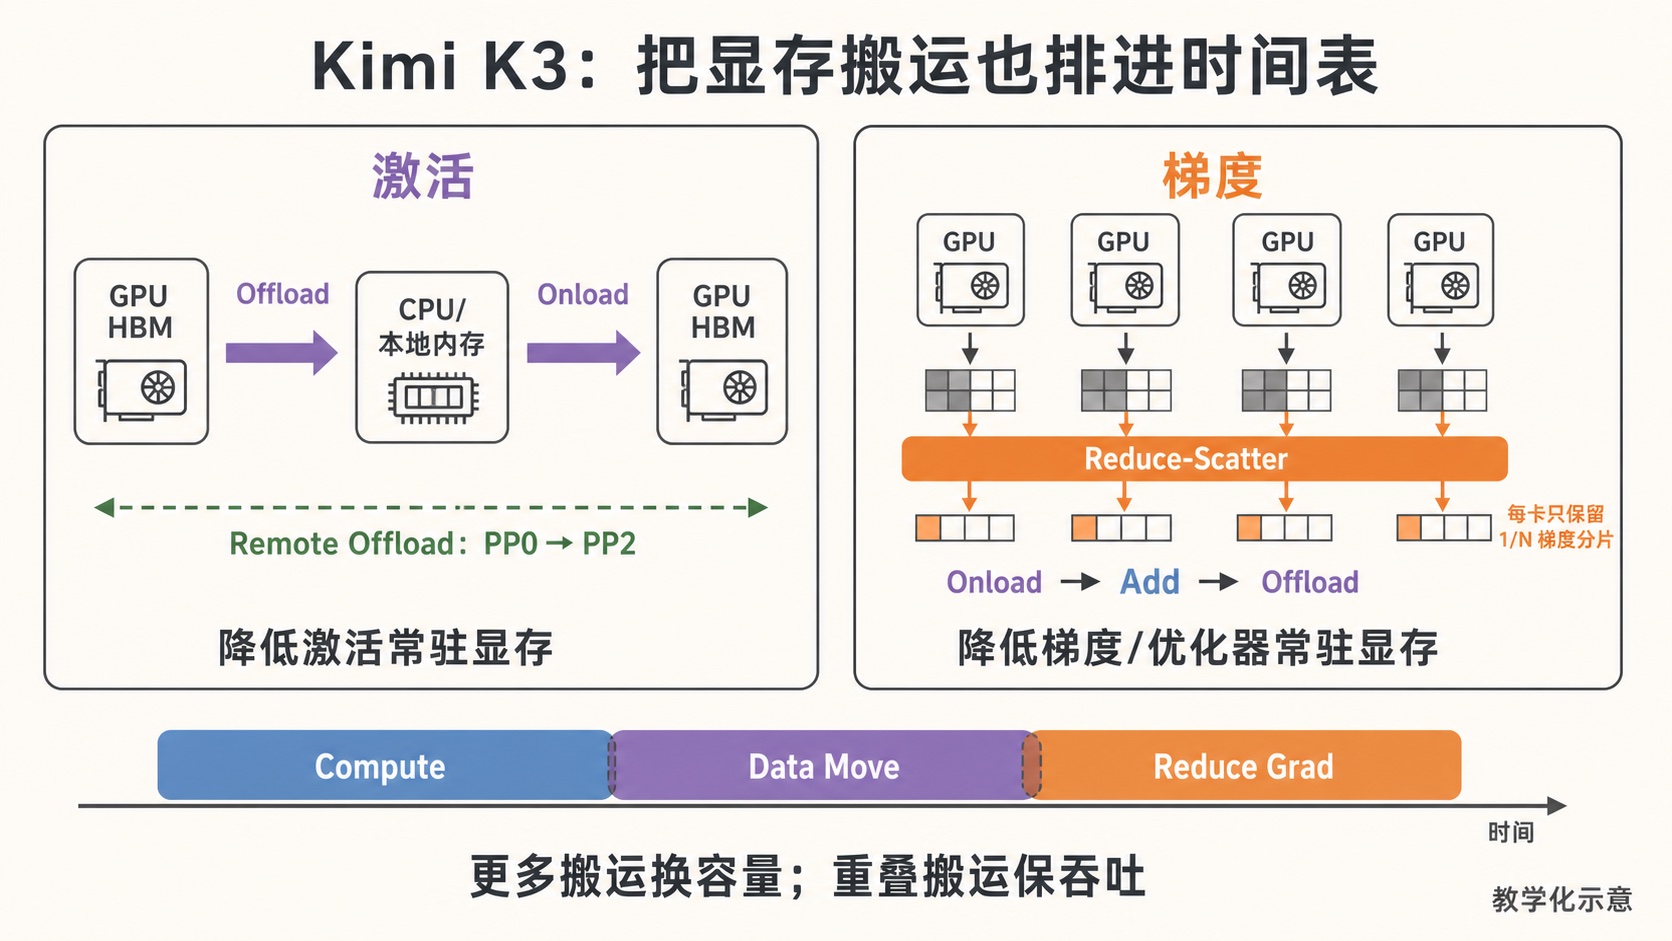
图 15|Kimi K3 的激活卸载与梯度分片
官方来源:Kimi K3 Technical Report · MoonshotAI/Kimi-K3
13 · 学习检查点
□ 基础:手画四个 Stage 的 GPipe 前向与反向时间线
□ 经典:比较 GPipe、1F1B 与 VPP 的气泡和激活峰值
□ 工程:用 Profile 区分 Stage 不均、通信暴露和显存瓶颈
□ 前沿:解释 Zero Bubble 为什么把 dX 放在 dW 前面
□ 长上下文:解释“等 Token 切分”为什么不等于“等计算量切分”
□ 论文:选择一种前沿调度,复现其依赖图和时间线
14 · 论文与源码
基础与经典调度
GPipe:Efficient Training of Giant Neural Networks using Pipeline Parallelism
Megatron-LM:Efficient Large-Scale Language Model Training on GPU Clusters
PipeDream-2BW:Memory-Efficient Pipeline-Parallel DNN Training
Chimera:Bidirectional Pipelines for Scalable DNN Training
前沿调度
Zero Bubble Pipeline Parallelism
Pipeline Parallelism with Controllable Memory
Seq1F1B:Efficient Sequence-Level Pipeline Parallelism for Large Language Model Training
SlimPipe:Memory-Thrifty and Efficient Pipeline Parallelism for Long-Context LLM Training
DeepSeek-V3 Technical Report:DualPipe
AMDP:Asynchronous Multi-Directional Pipeline Parallelism(ICML 2026)
OptPipe(预印本方向;OpenReview 页面标记为 withdrawn)
当前工程实现