1.14 扩展长时间运行的自主编码能力 · Cursor
这篇博客主要是关于多agent实验。
单个agent专注执行小任务时表现不错,但是在复杂项目中是否缓慢。我们自然会想到并行多个agent,但如何协调多个agent是一个非常困难的任务。
Cursor认为,先进行规划再执行任务,可能会导致执行过于僵化。而推进一个大型项目的路径往往并不明确,在一开始也无法做清晰的工作拆分,于是他们从动态协调入手,让 Agent 根据其他 Agent 此刻正在做的事情来决定自己的下一步。
每一个agent会领取一个任务,当然,为了防止多个agent抢占同一个任务,cursor使用了锁机制。但是锁没有带来正向的收益,agent要么持有锁太久,要么干脆忘记释放锁。即使锁正常工作,它也会成为瓶颈,将会使大部分agent时间花在等待上,20个agent实际效率只相当于两三个agent。cursor尝试过更简单的方法,但深层问题依然存在。
而且在没有层级结构的情况下,agent会变得非常规避风险。遇到困难任务,它们会选择回避,转而做一些小而安全的修改。这就导致没有一个agent愿意站出来解决难题,所有的agent看起来都在工作,但实际的进度在空转。
我们自然会想到,给agent分层级,有专门做计划的,有做执行的。注意,这里将规划和执行的agent分开并不是我们刚刚说的“先规划再执行任务”,这个是静态的设计,而将agent分为planner和worker是动态的设计。此外,cursor还做了一个评审agent用于判断任务是否完成,是否继续。下一轮的迭代也会从干净的初始状态重新开始。
cursor用这套设计做了一些实验,比如从零构建一套浏览器和将 Solid 迁移到 React。具体实验不做介绍,我们来看看cursor从这两个实验中总结出了什么经验。
这些实验消耗了数万亿的token(我几个月才用了500亿),显然这套系统并不高效。但是他们发现,不同的模型适合不同的角色,需要对每个角色选择最适合的模型,而不是依赖单一的通用模型。而且cursor做的许多改进来自于“减法”而不是“加法”,我在开发自己的项目时也对这一点深有体会。而提示词可能比框架,甚至模型,更为重要。
我在设计自己的自动化系统时,也会为提示词头痛。你需要去深度思考,究竟哪些部分应该成为静态上下文,哪些成为动态上下文,提示词的前后顺序如何布置,如何按照我的想法来实现整个流程。现在看到cursor对提示词如此关注,我也非常开心,说明自己的时间用到了真正有意义的事情上。
但也要注意,这是2026年初的技术博客,如今我们应该如何编排multi agent,仍然需要仔细思考。对于简单的,中等难度的任务,目前的sota模型astra或者fable 5.1在有良好的提示词下能完成的非常好,但是想要提高效率,降低成本,或者探索更复杂,更困难的问题,还是需要多agent配合工作。毕竟一个session是串行的,多个session工作时间成本会更低,但不经过context管理和设计的多agent工作会带来负收益。
当然,复杂的问题可能也不需要多agent,可能存在其他方向,目前我也在不断探索。
1.15 打造更强大的 Bugbot · Cursor
随着代码agent 能力不断增强,我们用于review的时间也越来越多。在我平时的开发中,我会定时做code review以及消融实验,确保整体代码的整洁性。而cursor针对debug开发了一个bugbot,在找bug方面相较普通智能体有较大的提升。
最开始使用的方法是并行启动检测,用多数投票来合并结果。当多轮检测都独立标记出一个问题时,即视为该缺陷真实存在的强信号。Bugbot的流程如下:
- 使用随机化 diff 顺序并行执行 8 轮检测
- 将相似的缺陷合并到同一个分组中
- 用多数投票过滤掉只在单轮检测中出现的缺陷
- 将每个分组合并为一条清晰的描述
- 过滤掉不需要的类别(例如编译器警告或文档错误)
- 将结果交给验证模型以识别误报
- 与之前运行中已报告的缺陷去重
为了将bugbot真正投入使用,cursor用rust重写了他们的bugbot与 Git 仓库交互的底层模块。同时为了适配不同团队的不同要求,cursor也推出了bugbot rules。这些方法让bugbot可靠且易于适配。但是有一个关键问题,如何定量bugbot在真实环境的表现,这也是所有agent harness,模型训练任务都十分关注的问题。
需要说明的一点是,cursor这篇博客发表之时,bugbot只关注于找bug,还没有开始修bug,在一个月后,cursor更新了autofix功能,那时的bugbot将会具备修bug的能力。
为了衡量bugbot找bug的效果如何,cursor设计了一个名为“解决率”的指标:当PR合并时,由AI判断代码作者实际修复了哪些问题。比如bugbot给我报了100个错误,我最后只修了50个,因为另外50个是误报,我不会关注。在开发这个指标时,cursor和代码作者一起抽样检查,发现llm做这个“已解决”和“未解决”的分类任务准确度非常高。 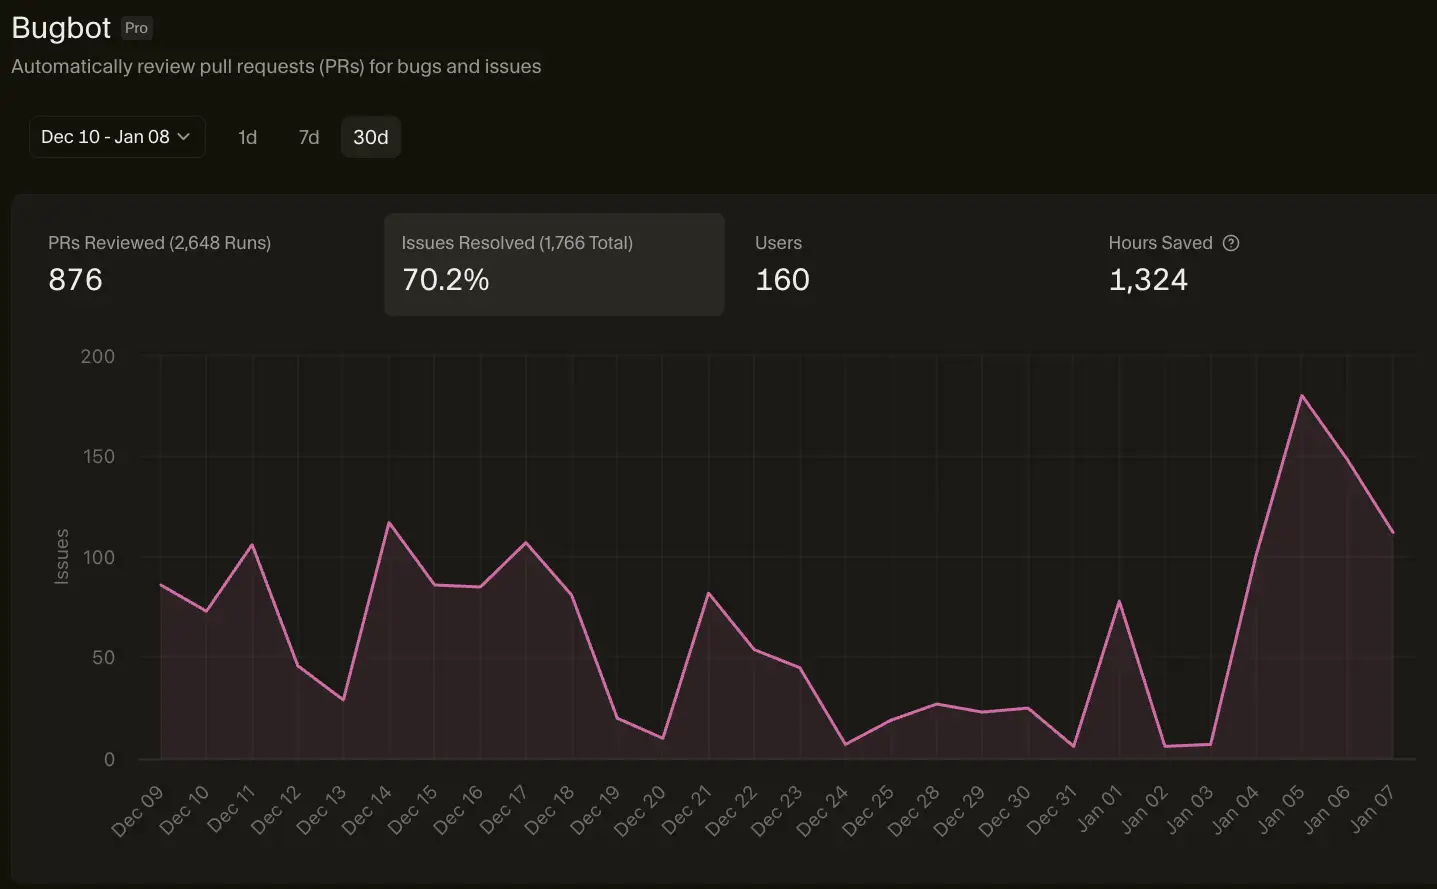 从解决率的角度,可以判断bugbot发现的问题中,有多少是工程师会真正修复的真实问题。这个指标相对于其他衡量标准确实更有效,清晰。
当然,cursor也建立了一套自己的bugbench,用于线下辅助迭代bugbot。他们利用bugbench和解决率两个指标来做“爬山式优化”,同时围绕模型、提示词、迭代次数、验证器、上下文管理、类别过滤和 Agent 设计等方面运行了数十个实验。出人意料的是,许多改动都让指标下降了。这也进一步强调,可能“减法”比“加法”更重要。
cursor在2.26更新了bugbot autofix(用 Bugbot Autofix 完成代码评审闭环 · Cursor),但只是简要介绍功能,感兴趣的朋友可以点击查看。
1.27 安全地为大型代码库建立索引 · Cursor
Cursor 会在你打开项目时为你的代码库构建一个可搜索的索引,对于小型项目,这几乎是瞬间实现的,但是对于大型项目,初始建立索引可能需要几个小时,而且索引没建立到足够完整之前,Agent 基本无法使用语义搜索能力。
但大多数团队实际使用的几乎是完全相同的代码库副本。cursor计算,同一组织,不同用户之间的同一代码库克隆版本的相似度平均达到 92%。也就是说,有新成员加入时,无需从头重建索引,而是直接复用队友的索引。对于超大的代码仓库,这将使得首次查询的等待时间从几小时缩短到几秒。
cursor使用默克尔树来构建代码库的初始视图,你可以通过我的jerry了解什么是默克尔树。这使得agent不需要重新处理一遍内容,就能检测到哪些文件和目录发生了变化。
但是注意到这篇博客中,cursor使用embedding来做语义索引,而如今是否还使用embedding,我需要check一下。后续的段落主要是介绍一些默克尔树的基本特性,有时间我再来补充。