由于最近做的项目和cursor做的有一些交集,也浏览了一些cursor的blog,发现了很多有趣的知识,一时兴起想盘一盘cursor今年做了哪些研究和实验。
所有blog引用于:Blog · Cursor
1.6 Dynamic context discovery · Cursor
非常有意思的研究,给agent更少的细节,反而能让agent自主提取上下文。
很显然,agent在tool call 的时候,可能会拿到很长的Json格式的输出,那么在这种情况下,我们要如何设计,避免这种信息占用过多的context资源?
你会想到精简工具返回的格式,高频调用的tool需要着重优化。可是真实的工作环境是:你需要调用很多第三方的tool,你根本没有时间和精力去优化这些第三方tool返回的格式,并且你使用的code agent自带了很多tool,即使你想优化也找不到入口。
如果你设计一个简单的规则,命令拿到的输出过长就直接截断,那可能会导致数据丢失,而且可能负面影响大于收益。
而cursor通过将tool的输出写入文件,赋予agent读取该文件的能力。并且agent通过tail命令来读末尾内容,如果有需要再扩大读取范围。这个方法确实很简洁,值得借鉴。
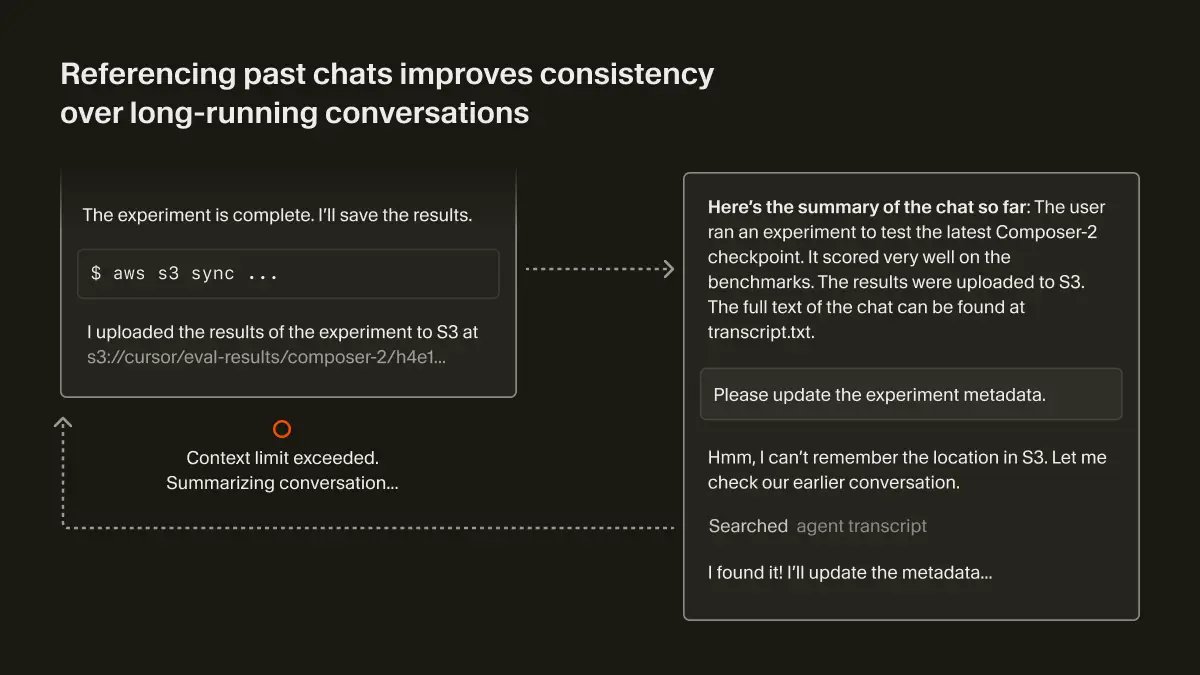
当context窗口满了,需要压缩的时候,怎么办?因为摘要压缩是有损的,会导致agent对上文的掌握情况变差。
cursor将对话历史作为文件,来提升摘要的质量。同样,agent只有在需要的时候,再去读对话的内容,也是动态的上下文加载。
 codex的compact机制也很巧妙,有时间写一篇短文聊聊。
而比较难解决的是mcp,mcp 服务器通常包含很多工具,且往往会有很长的描述,这会显著膨胀上下文窗口,而实际上很多工具根本不会被使用。cursor的解法也很简单,他们将工具描述同步到一个文件夹,为 mcp 提供了动态上下文。agent只会收到包含工具名称的一小段静态上下文。只有在任务需要的时候,才去查找具体的工具,读细节。他们在AB测试中发现这种策略在调用mcp的过程中能让总 token 消耗减少 46.9%。
如果你玩过powershell,并且尝试过从terminal中配置环境(比如复现一篇复现不出来的论文),你一定会遇到过一大堆报错,满屏都是字,但好歹这种报错能看懂。但是一些日志文件,是真的看不懂,一大堆id,一大堆看不懂的字段。你可以使用tail -f app.log | grep -i error,是的,cursor也是这么设计的。他们将终端的输出同步到本地文件系统,使用grep来动态加载上下文。
文章最后也提到,不能确定文件是否会成为基于 LLM 的工具的最终接口形式,who knows?
但是这篇文章对我的启发非常大,我在设计我自己的项目时,其实更多是在考虑静态的文档要怎么写,对动态加载上下文的思考偏少。这是一个非常关键的点。如果你给模型太多的静态上下文,那它用于推理、用于工作的上下文就被大幅地缩短,这对整个任务来说是灾难性的。
1.9 使用智能体编码的最佳实践 · Cursor
这篇博客主要是聊一聊使用Cursor的相关技巧。
cursor将Harness定义为 sp+rule+tool+model。不同的模型由于训练数据,可能对工具的调用会有不同的偏好,因此想要使用好模型,需要给他额外的一些约束。且这个约束会随着模型的进化不断调整。
cursor认为,在编写代码之前要先进行规划。我在日常的工作中也使用plan,只是我用自己的提示词引导agent做计划。之前试过codex的plan,感觉它做的计划过于复杂和冗余,因此后来没有使用自带的计划模式。
有意思的是,cursor认为如果agent 生成的内容并不符合你的预期,与其试图通过后续提示来修修补补,不如回到计划本身。直接回滚这些改动,重新细化计划,把需求描述得更具体,然后再运行一次。这样通常比修一个进行中的 agent 更快,生成的结果也更干净利落。
我们在平时的工作中会发现,使用一个较长的session有时候不会给agent带来更好的效果,你会发现agent的注意力较为分散。因为超长的上下文在压缩后常常会把我们想要的信息丢失,积累噪声。那么问题来了,我们什么时候开始一个新的对话?
cursor列出了以下三点:
- 你要切换到一个不同的任务或功能
- Agent 看起来很困惑,或者总是在犯同样的错误
- 你已经完成了一个逻辑完整的工作单元
cursor还有一个好用的功能,可以使用@Chats引用过去的对话,agent会有选择的去读取聊天记录,只提取它想要的上下文。但是我看了下云端的cursor好像暂未支持这个技能,本地的cursor可以使用@,不过我日常使用云端cursor,所以没体验过这个功能。但是我好奇的是,agent如何提取到它想要的上下文,后面要关注一下这里。
cursor的静态上下文放到了rules,和我一样。rules应该保持足够简洁,并且可以指向引用文件。不能过度优化规则,且不能为极少的边缘情况添加指令。只有发现agent反复犯同样错误的时候,再去新增规则。
而skill则是作为一个动态能力,既能保持上下文的足够简洁,又能让agent掌握一些专业能力。可以将skill理解为agent的小程序,哪里不会点哪里~
cursor提供了几种不同类型任务的开发模式,非常有用,这里我就不用自己的语言表述了,大家直接看cursor官方的原文:
- 测试驱动开发(TDD)
智能体可以自动编写代码、运行测试并进行迭代:- 让智能体根据预期的输入/输出对编写测试。 要明确说明你在做 TDD,这样它就会避免为尚不存在的功能编写模拟实现。
- 让智能体运行测试并确认测试确实失败。 明确说明在这个阶段不要编写实现代码。
- 在你对测试满意后提交这些测试。
- 让智能体编写能通过测试的代码,并指示它不要修改测试。告诉它持续迭代,直到所有测试通过。
- 在你对改动满意后提交实现代码。
当智能体有清晰的迭代目标时,它的表现最好。测试可以让智能体在不断修改的同时评估结果,并逐步改进直到全部通过。
2. 理解代码库
在接手一个新代码库时,可以使用 Agent 来进行学习和探索。像向队友请教一样提问:
“这个项目里的日志是如何运作的?”
“我该如何添加一个新的 API endpoint?”
“CustomerOnboardingFlow 处理了哪些边界情况?”
“为什么我们在第 1738 行调用的是 setUser() 而不是 createUser()?”
Agent 会同时使用 grep 和语义搜索在整个代码库中查找答案。这是快速上手陌生代码库的最高效方式之一。
3. Git工作流
Agent 智能体可以查找 Git 历史记录、解决合并冲突,并自动化你的 Git 工作流。
例如,一个 /pr 命令可以提交、推送代码并打开一个 pull request:
为当前更改创建 Pull Request。

1. 使用 `git diff` 查看已暂存和未暂存的更改
2. 根据更改内容编写清晰的提交信息
3. 提交并推送到当前分支
4. 使用 `gh pr create` 创建 Pull Request,并提供标题和描述
5. 完成后返回 PR URL
命令非常适合你每天会多次运行的工作流。将它们保存为 Markdown 文件放在 .cursor/commands/ 中,并提交到 git,这样整个团队都可以使用。
我们使用的其他命令示例:
/fix-issue [number]:使用gh issue view获取 issue 详情,查找相关代码,进行修复并打开一个 PR/review:运行 linter 工具,检查常见问题,并总结可能需要关注的内容/update-deps:检查过时依赖项并逐个更新,每次更新后运行测试
Agent 智能体可以自动使用这些命令,这样你就可以只通过一次 / 调用来委托多步工作流。
Cursor还提供了code review相关的功能,在agent工作过程中,你可以看到实时的diff,因此当你发现agent修改方向不对时,点击stop,重新引导。但我认为这个功能要取决于具体的场景,可能只有部分场景适用,大部分场景agent会瞬间修改大量的代码,人类无法实时查看diff。但在一些rubric文档或者judge pe中,这些diff是需要人类审阅的。
cursor也做了很多bot,用于自动化流程,这个我后续会在一篇单独的文章中进行分析。自动化的流程对所有公司都会带来极大的效率提升,是值得投入时间的。
当任务是对代码进行重大变更,此时无法对code逐行review,因此可以让agent帮你生成架构图。cursor提供了这样一段提示词:
Create a Mermaid diagram showing the data flow for our authentication system, including OAuth providers, session management, and token refresh
架构图会非常有利于了解变动的信息,并且能在code review之前发现架构的重大问题。
cursor认为,让多个模型同时尝试解决同一个问题,再从中选出最优结果,可以显著提升最终输出质量,尤其适用于更棘手的任务。但这个方法我认为不一定是个好方法,相当于在抽卡,抽一次就中的概率低,那抽10次抽中的概率就会稍大。可是对于真正复杂的问题,抽一万次都不会得到好结果,而这类问题的解决方法在我还未公开也还没开发的开发项目里(hhhha),但我认为那会是个正确的方向。
blog提到云端agent,这是cursor非常吸引我的地方,也是我订阅cursor的原因之一。写到这里不妨聊聊我订阅cursor的几个主要原因:
- cursor是当下唯一不被封号就能使用fable5/5.1的平台。
强大的模型相比普通模型,在提供建议,方向决策上会有指数级的差距。 - cursor有云端环境。
我可以基于github仓库进行开发,不需要本地环境。对于多设备的我来说非常有用。 - cursor对slack的支持非常好,原生支持多人协作。
虽然我现在用不上这个功能,因为当前的项目都是自己开发,或者和少数几个人一起协作,用微信或者飞书就够了。但一套多人协作的agent infra是非常非常重要的。 - cursor订阅赠送grok bot
grok bot可以理解为封装好的openclaw。我之前为了让我的hermes在云端运行,买了一个45刀一年的服务器,部署好后又头疼与各种api接口的连接,比如我最常用的google calendar。我没有时间一个一个点击按钮设置权限,而且这些权限一段时间后需要重新授权,实在是非常折腾。因此我只让我的hermes每天跑一些auto harness的任务,但还需要不断维护。
而grok bot自带一台16g运行内存的云电脑。man!你知道一台16g带gui的服务器一年多少钱吗?我的astra找到的最低价格是735人民币。这已经算非常便宜的了,我的阿里云服务器0.5G的运行内存一年要我330人民币......
同时,grok bot的api额度是和cursor分开的,真的感觉马斯克是大善人哈哈哈哈。 - cursor可以使用支付宝支付,即使我已经有合法的海外支付方式
但我订阅的是最低档的cursor pro,其中最大的原因是公司不报销cursor,且我日常使用codex 20x的订阅套餐。毕竟cursor额度里的grok 4.6效果一般,在真实工作中时间效率更为重要,所以主力还得是codex。而且codex的computer use是sota级别,astra更新后又和其他厂商拉开了差距。
回到主题,cursor的云端agent会clone github仓库并且创建一个branch,工作后自动提交pr。并且cursor还设计了debug mode,读到这里我就想起来在vs code里的debug中打点debug哈哈哈。但是显然,这些mode在开发过程中非常重要,但理想的方法是让agent自动选择模式,而不是人去指定agent去plan,去debug。
能最大化利用 agent 的开发者有什么共同特点?我将cursor的原文列在下面:
- 他们会写具体的提示。 指令越具体,agent 的成功率就越高。对比一下“add tests for auth.ts”和“Write a test case for auth.ts covering the logout edge case, using the patterns in
__tests__/and avoiding mocks.”。 - 他们会不断迭代自己的配置。 从简单开始。只有当你发现 agent 一再犯同样的错误时,才添加规则。只有当你摸索出一个想要重复使用的工作流程时,才添加命令。在真正理解自己的模式之前,不要过度优化。
- 他们会认真 review。 AI 生成的代码看起来可能是对的,但实际上可能存在细微错误。阅读 diff,并认真进行 review。agent 工作得越快,你的 review 流程就越重要。
- 他们会提供可验证的目标。 agent 无法修复它“看不见”的问题。使用强类型语言,配置 linters,并编写测试。给 agent 明确的信号,以判断更改是否正确。
- 他们把 agent 当作有能力的协作者。 让它给出计划,要求它解释,对你不认可的方案要敢于提出质疑。
但是这种开发方式是否已经落后?因为这篇cursor博客是2026年初撰写的,那2027年初的开发方式会是什么样?